Агентҳои зеҳни сунъӣ
Китоб дар бораи он, ки агентҳои зеҳни сунъӣ чӣ гуна кор мекунанд, чӣ гуна онҳоро бояд сохт ва чӣ гуна бехатар ва боэътимод ба кор андохт: давраи «мулоҳиза — амал — мушоҳида», абзорҳо, меъмориҳо, хотира, арзёбӣ ва иҷрои бехатар.
Агенти Зеҳнӣ · 20 октябри 2026 · 17 саҳифа
Боби 13. Банақшагирии пешрафта, андешаронӣ ва иҷрои миқёспазир дар агентҳо
Боби 13. Банақшагирии пешрафта, андешаронӣ ва иҷрои миқёспазир дар агентҳо
Барои хонандагони пешрафта. Ин боб ихтиёрӣ аст. Дар он омӯзонидани агентҳо бо омӯзиши тақвиятӣ (RL), формулаҳо ва коди омӯзиш, ки ба GPU ниёз дорад, оварда шудаанд. Ғояҳои асосии он бе формула дар охири боби 7 («Пеш назар: агентҳо чӣ гуна беҳтар мешаванд») шарҳ дода шудаанд. Агар китобро бори аввал мехонед, метавонед ин бобро гузаронед ва ба боби 14 гузаред.
Дар бобҳои 6 ва 7 дидед, ки агентҳои зеҳни сунъӣ сеҳру ҷоду нестанд: онҳо системаҳои муҳандисишудаанд. Аммо усулҳое, ки дар ин боб меомӯзед, шояд ба сеҳр наздик намоянд. Чунонки Артур Кларк гуфтааст:
Ҳар технологияи ба қадри кофӣ пешрафтаро аз сеҳру ҷоду фарқ кардан ғайриимкон аст.¹
Ин ҳисси сеҳромез вақте пайдо мешавад, ки агентҳо дигар танҳо вокуниш нишон намедиҳанд, балки аз таҷрибаи худ меомӯзанд ё ҳангоми санҷиш қарорҳои оқилонатар мегиранд. Онҳо, ҳадди ақал ба маънои маҷозӣ, дигар персонажҳои ғайрибозигар (NPC) нестанд, зеро танҳо аз рӯйи сенарияи собит амал намекунанд. Вақте принсипҳои омӯзиш бо тақвият (Reinforcement Learning — RL)-ро ба моделҳои бузурги забонӣ (LLM) татбиқ мекунед, онҳо ба омӯзиш ва мутобиқшавии мустақилона оғоз мекунанд. Ҳамин тавр, гуфтаи Кларк дар ҷаҳони агентҳои AI маънои нав мегирад.
Аммо он чизе, ки дар аввал ғайриодӣ менамояд, дар асл аз маҷмӯи механизмҳои равшан бармеояд. Ин боб он механизмҳоро муфассал мефаҳмонад: меомӯзед, ки RL чӣ гуна байни андешаронӣ ва натиҷаҳо ҳалқаи бозхӯрд месозад ва чӣ гуна ҷустуҷӯи дарахтӣ ва банақшагирии мутобиқшаванда ба агентҳо имкон медиҳанд, ки пеш аз амал чанд ояндаи имконпазирро моделсозӣ кунанд ва қарор диҳанд: оё беҳтар аст роҳҳои ҳалли бештарро ҷустуҷӯ кунанд ё як роҳи ҳалли эҳтимолиро такмил диҳанд.
Ҳар яке аз ин механизмҳо ба таассуроти худтакмилдиҳӣ саҳм мегузорад. Ин, албатта, ҳамон раванди такмилест, ки агентҳо тавассути он бо гузашти вақт беҳтар мешаванд. Агентҳо бозхӯрд ҷамъ мекунанд, интихоби худро таҳлил мекунанд ва рафторашонро ба тарзе такмил медиҳанд, ки гӯё зинда бошанд. Мукофотҳо, ҳалқаҳои бозхӯрд ва аз нав банақшагирии динамикӣ бо чаҳорчӯбаҳои RL, аз ҷумла Agent Reinforcement Trainer (ART), relative universal LLM-elicited rewards (RULER) ва reinforcement learning for language models (rLLM), пайваст мешаванд. Дар натиҷа, давраи такмили пайваста ба вуҷуд меояд, ки ҳам омӯзиш ва ҳам ба истифода додани системаро фаро мегирад.
Дар ин боб аз марзи байни тарҳрезӣ ва мустақилият мегузаред. Агентҳои AI-и шумо дигар танҳо аз рӯйи сенария амал намекунанд ва ба ҳалли мустақилонаи масъалаҳо оғоз мекунанд. Вақте пешбинӣ, тақвият ва иҷрои миқёспазир якҷоя кор мекунанд, лаҳзаи муҳим фаро мерасад: ба назаратон агентҳо дигар танҳо тавассути оркестратсия идора намешаванд. Дар ин ҷо тавассути RL ба агентҳо қобилияти интихоб ва такмил медиҳед: системаеро месозед, ки омӯзад, мулоҳиза кунад ва беҳтар шавад. Ин боб ба шумо ёрӣ медиҳад, ки пайдоиши қобилияти амал кардани мустақилонаро дар агентҳоятон тарҳрезӣ кунед.
Фаротар аз бозиҳои ҷамъашон сифр: аз мукофот то андешаронӣ
Агар боре фикр карда бошед, ки омӯзиш дар RL воқеан дар куҷо рух медиҳад, ин бахш оғози онро мефаҳмонад. Ҳама чиз аз мукофотҳо оғоз мешавад: сигналҳое, ки ба агент мегӯянд, оё хуб амал кардааст ё не. Аммо танҳо мукофотҳо системаро зеҳнманд намекунанд. Онҳо бозхӯрдеро ба вуҷуд меоранд, ки системаро ба беҳтаршавӣ водор мекунад.
Дар асл, асоси RL сода аст. Ҷиддӣ мегӯем. Лаҳзае фикр кунед: агент амалеро анҷом медиҳад, натиҷаро мушоҳида мекунад ва онро барои интихоби беҳтар дар дафъаи оянда истифода мебарад. Вақте ин давра такрор мешавад, қонуниятҳо пайдо мешаванд. Агент мефаҳмад, ки чӣ кор медиҳад ва чӣ кор намедиҳад. Дар ҳамин лаҳза ҳалқаи байни дарк ва ислоҳ баста мешавад ва рафтор мақсаднок менамояд. Шумо аллакай дар зиндагӣ чунин мекунед: ҳар рӯз, бе он ки дар ин бора фикр кунед, аз таҷрибаи худ меомӯзед ё ба фарзандон ва ҳайвоноти хонагиатон чизе меомӯзонед. Ҷадвали 13.1 истилоҳҳои маъмули RL-ро муқоиса мекунад. Дар ин боб RL-и онлайн, on-policy ва model-free истифода мешавад.
Ҷадвали 13.1. Навъҳои омӯзиши RL дар як нигоҳ
| Истилоҳ | Маъно |
|---|---|
| RL-и онлайн (Online RL) | Агент ҳангоми омӯзиш таҷрибаи нав ҷамъ мекунад. Дар ин боб ин маънои тавлиди иҷроҳои нави пурра бо сиёсати ҷорӣ, баҳодиҳии онҳо ва навсозӣ аз рӯйи траекторияҳои навҷамъшударо дорад. |
| RL-и офлайн (Offline RL) | Сиёсат аз маҷмӯи собити траекторияҳои қаблан ҷамъшуда омӯзонида мешавад. Ҳангоми омӯзиш маълумоти нави ҳамкорӣ бо муҳит ҷамъ намешавад. |
| On-policy | Траекторияҳои барои навсозӣ истифодашаванда аз ҳамон сиёсате гирифта шудаанд, ки такмил дода мешавад. |
| Off-policy | Траекторияҳои барои навсозӣ истифодашаванда аз сиёсати дигар, версияи кӯҳнаи модел, рафтори сабтшуда, намунаҳои инсонӣ ё агенти дигар гирифта шудаанд. |
| RL бе модели муҳит (Model-free RL) | Агент аз ҳамкорӣ ва бозхӯрди мукофот меомӯзад, ки кадом амалҳо натиҷаҳои беҳтар медиҳанд, бе он ки модели тағйироти ҳолати муҳитро мустақиман омӯзад. |
| RL бо модели муҳит (Model-based RL) | Агент модели тағйир ёфтани муҳитро пас аз амалҳо меомӯзад ё истифода мебарад. Сипас пеш аз амал онро барои банақшагирӣ ё симулятсия истифода мекунад. |
Ягона фарқ дар он аст, ки барои агентҳои LLM ин ҳалқа дар фазои дигар рух медиҳад: он ҷисмонӣ нест. Ин раванд дар забон, фикр ва андешаронӣ мегузарад. Ҳар паём, ҳар даъвати абзор ва ҳар натиҷаи мобайнӣ қисми траектория мешавад. Траектория сабти пурраи он аст, ки агент чӣ гуна аз дархости аввал то натиҷаи ниҳоӣ қадам ба қадам ба ҷавоб расидааст. Расми 13.1 ҷараёни вақти иҷро ва сабти траекторияро нишон медиҳад. Расми 13.2 бошад, асосҳои ҳалқаи омӯзиши RL-ро дар як нигоҳ ҷамъ мекунад: лаҳзае, ки амал ба бозхӯрд ва бозхӯрд ба такмил табдил меёбад.
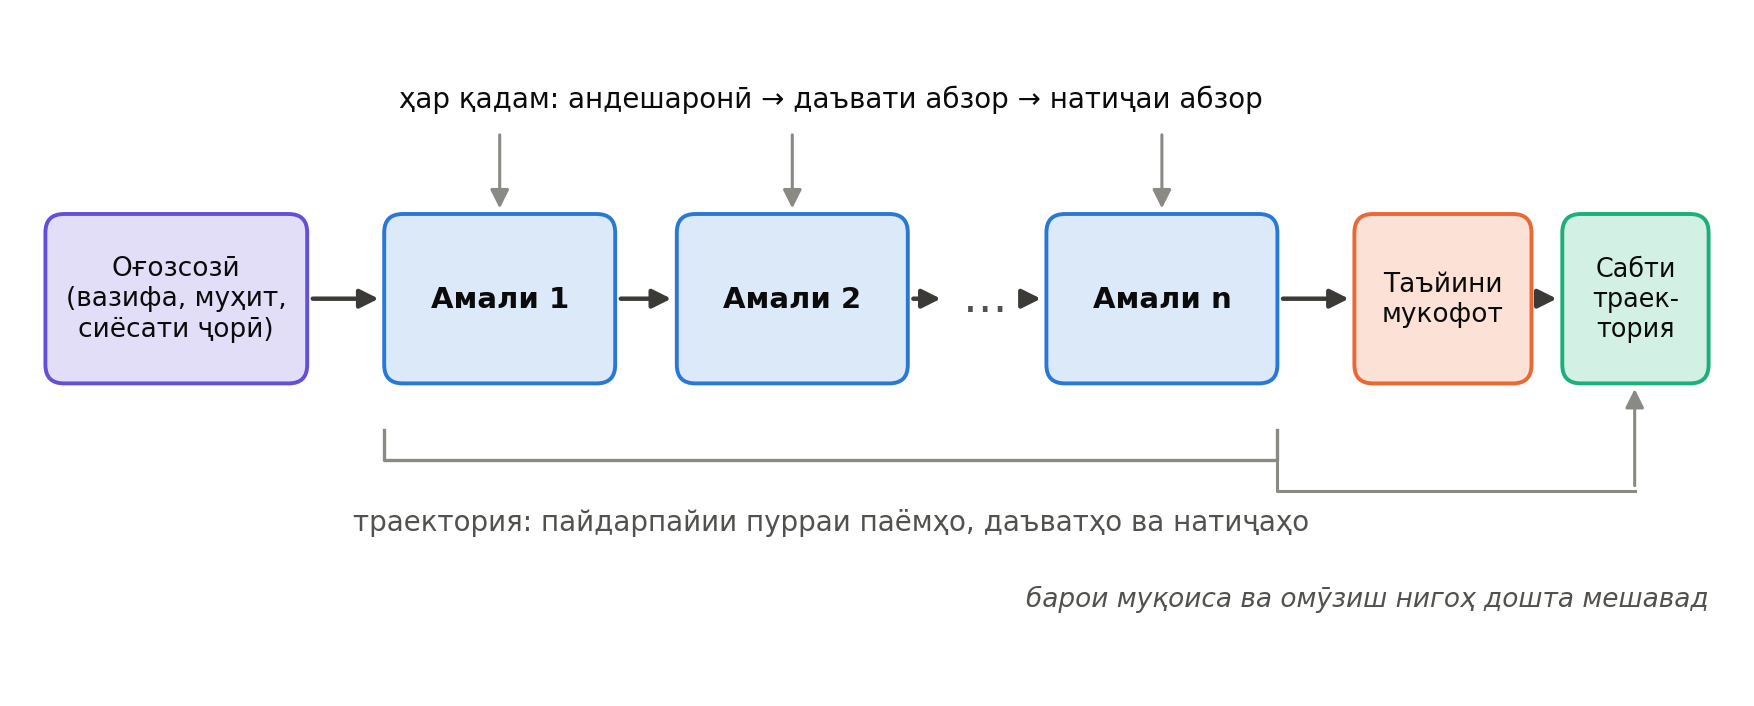
Расми 13.1. Ҷараёни вақти иҷрои пурра: оғозсозӣ, амалҳои пайдарпай, таъйини мукофот ва сабти траектория.
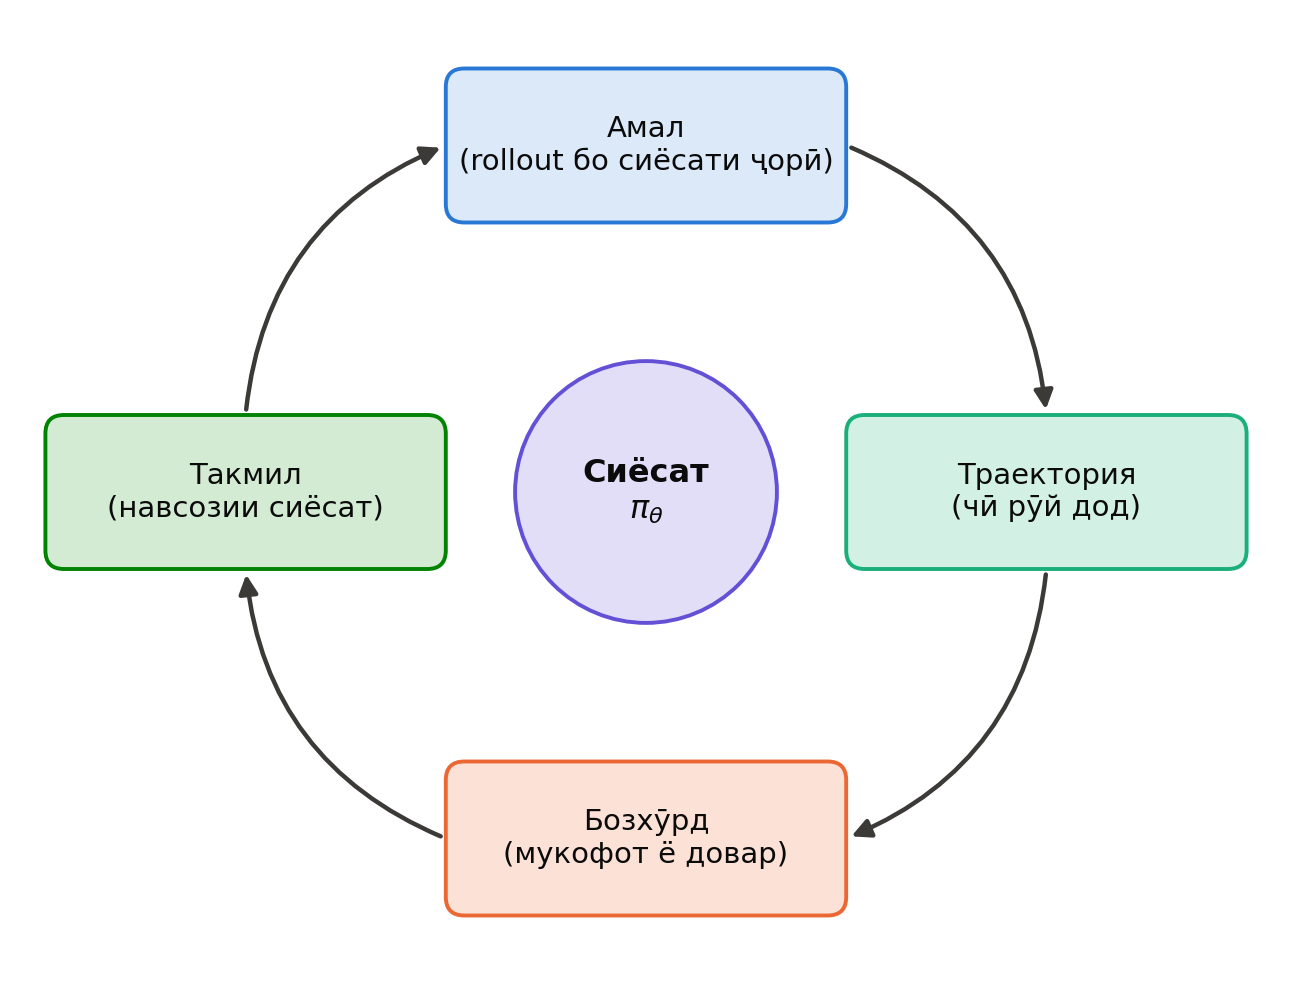
Расми 13.2. Ҳалқаи омӯзиши агент: аз амал ба бозхӯрд ва аз бозхӯрд ба такмил.
Вақте чанд траектория ҷамъ мекунед, иҷроҳои пурра — rollout — ба даст меоред. Ҳар rollout як қиссаи пурраи андешаронӣ аст. Баъзеҳо ба ҳадаф мерасанд, баъзеҳо ноком мешаванд, аммо ҳамаашон ба агент меомӯзонанд, ки қарорҳои худи ӯ чӣ гуна натиҷаҳои гуногун ба бор меоранд. RL ин таҷрибаҳоро ба сохтор табдил медиҳад: пайдарпайиҳои хоми матнро ба робитаҳои ченшавандаи сабабу натиҷа мубаддал мекунад. Пеш аз баррасии тарзи истифодаи онҳо, ҷадвали 13.2 барои фаҳмидани ин мафҳумҳо роҳнамо медиҳад.
Ҷадвали 13.2. Мафҳумҳои RL
| Мафҳум | Маъно | Аҳамият барои агентҳо |
|---|---|---|
| Мукофот (Reward) | Сигнале, ки мегӯяд натиҷа хуб буд ё бад. | Мукофот ҳалқаи амал ва оқибатро мепайвандад. Бе он агент ҳисси пешрафт надорад. |
| Траектория (Trajectory) | Пайдарпайии пурраи қадамҳои андешаронӣ, амалҳо ва даъватҳои абзор, ки ба натиҷа мебаранд. | На танҳо қарор, балки тарзи расидан ба онро сабт мекунад. |
| Иҷрои пурра (Rollout) | Як иҷрои комили як ё чанд траектория барои вазифа. | Таҷрибаи агентро сабт мекунад, то онро муқоиса, баҳодиҳӣ ва барои омӯзиш истифода бурдан мумкин бошад. |
| Сиёсат (Policy) | Қоидаи дохилии қароргирии модел, ки контекстро ба амали навбатӣ табдил медиҳад. | RL сиёсатро нав мекунад, то агент бо мурури вақт интихоби беҳтар кунад. |
| Модели мукофот ё довар | Моделе, ки траекторияҳоро арзёбӣ мекунад ва аз рӯйи сифат ё дурустӣ мукофот медиҳад. | Натиҷаҳои хомро ба сигналҳои омӯзиш табдил медиҳад. |
| Арзёбии нисбӣ | Муқоисаи чанд rollout барои муайян кардани беҳтарин иҷро. | Зарурати мукофотҳои дастӣ сохташударо кам мекунад ва такмил аз муқоисаро имконпазир мегардонад. |
Ба агент муаллиме лозим нест, ки ҳар қадамро тамғагузорӣ кунад. Танҳо роҳе лозим аст, ки траекторияҳои худро муқоиса кунад ва муайян созад, кадоме ба андешаронии беҳтар мебаранд. Дар амал, ин муқоиса аз сигнали мукофот меояд: аз модели мукофот, LLM ҳамчун довар (LLM-as-judge), санҷандаи барномавӣ ё бозхӯрди инсон. Дар ҳамин ҷо моделҳои мукофот ба кор медароянд. Системаҳои аввал қоидаҳои содаи дастӣ доштанд, аммо ин равиш барои агентҳои LLM, ки вазифаҳои кушода анҷом медиҳанд, чандон хуб кор намекунад. Агентҳои муосир бо арзёбии нисбӣ мустақиман аз муқоиса меомӯзанд. Онҳо барои як вазифа чанд rollout тавлид мекунанд ва онҳоро дараҷабандӣ мекунанд, то роҳи беҳтарини андешарониро ёбанд.
Такмили агент метавонад дар сатҳҳои гуногун рух диҳад
Вақте вазнҳои модел дастрасанд, бозхӯрд метавонад тавассути омӯзиши баъдӣ (post-training) ё RL сиёсати моделро нав кунад. Ҳангоми кор бо моделҳои пӯшидаи API, одатан худи модел собит мемонад. Аммо ҳамон траекторияҳо метавонанд системаи атрофи агентро беҳтар кунанд: промптҳо, тавсифи абзорҳо, мантиқи масирдиҳӣ, маҷмӯаҳои арзёбӣ, сиёсатҳои хотира ё тарҳи ҷараёни кор. Дар ҳар ду ҳолат, траекторияҳо рафтори агентро қобили санҷиш ва такмил мегардонанд.
Вақте агент ин корро оғоз мекунад, аз бозии ҷамъаш сифр фаротар меравад. Ӯ дигар танҳо талош намекунад як даврро бибарад; меомӯзад, ки тамоми раванди худро беҳтар кунад. Ҳадаф аз гирифтани ҷавоби дуруст ба андешаронии самараноктар мегузарад.
Ин нахустин «ҳилаи сеҳромез»-и воқеии RL барои агентҳо аст: модел аз траекторияҳои худ омӯзишро оғоз мекунад. Rollout-ҳоро ҳамчун хотира ва бозхӯрдро ҳамчун роҳнамо истифода мебарад. Он чизе, ки пештар озмоишу хато буд, ба такмили мақсадноки система табдил меёбад.
Дар гурӯҳ беҳтар аст: чаро дараҷабандии нисбӣ муҳим аст
Як траектория мегӯяд чӣ рӯй дод; гурӯҳи траекторияҳо нишон медиҳад чӣ метавонист рӯй диҳад. Омӯзиши воқеӣ аз муқоисаи онҳо оғоз мешавад.
Дар RL-и анъанавӣ модел аз мукофотҳои ададӣ меомӯзад, ки муваффақияти ҳар кӯшишро тавсиф мекунанд. Аммо барои агентҳои забонӣ таъйини ин ададҳо душвор аст. Эҷодкорӣ, ҳамоҳангии матн ё умқи андешаро бо як нишондиҳанда ба осонӣ баҳогузорӣ карда наметавонед.
Дараҷабандии нисбӣ ин мушкилро ҳал мекунад. Ба ҷойи додани холҳои мутлақ, ба модел иҷозат медиҳед чанд rollout-и як вазифаро муқоиса кунад ва муайян созад, ки кадоме беҳтар буд. Бозхӯрд ҳатман комил буданаш шарт нест; кофист, ки дар дохили гурӯҳ пайгирона бошад. Агар як траектория аз дигаре андаке беҳтар бошад, ҳамин фарқ аллакай барои роҳнамоии такмил иттилои кофӣ дорад.
Омӯзиш бо маҳдудият: дивергенсияи KL
Вақте ба агент аз таҷрибаи худ омӯхтанро ёд медиҳед, ҳамеша хавфе ҳаст, ки аз ҳад тез ё ба самти нодуруст омӯзад. Дар RL ин масъала фалсафӣ не, математикӣ аст. Агар сиёсати нав аз он чизе, ки модел аллакай медонад, аз ҳад дур шавад, модел рафторҳои муфидро фаромӯш мекунад.
Дивергенсияи Куллбак–Лейблер ё дивергенсияи KL ҳамон қисми муодилаест, ки аз ин пешгирӣ мекунад. Он чен мекунад, ки тақсимоти нави эҳтимолии сиёсати навшуда аз тақсимоти истинодӣ чӣ қадар фарқ дорад. Ба ибораи дигар, нишон медиҳад, ки «тарзи фикрронии» нав аз пешина чӣ қадар дур шудааст. Сиёсати навро бо (\pi_\theta) ва сиёсати истинодиро бо (\pi_{\mathrm{ref}}) ишора мекунем.
Агар ин фосила аз ҳад калон шавад, модел ба бозхӯрди охирин аз ҳад мутобиқ шуда, тавозунро гум мекунад. Бо илова кардани ҷаримаи KL ба ҳадафи омӯзиш, такмилро зери назорат нигоҳ медоред. Агент ҳамоно метавонад ҷустуҷӯ ва мутобиқ шавад, вале на то дараҷае, ки фаҳмиши пешинаи худро вайрон кунад.
Инро метавон ҳамчун тасмаи маҳдудкунандаи кунҷковӣ тасаввур кард: агент метавонад гаштугузор кунад, аммо хеле дур давида наметавонад. Ҳар навсозӣ созишест байни ду тамоюл: хоҳиши беҳтаршавӣ ва зарурати устувор мондан.
Ин идея асоси **беҳинасозии нисбии гурӯҳии сиёсат (Group Relative Policy Optimization — GRPO)**² ва **беҳинасозии гурӯҳии пайдарпайии сиёсат (Group Sequence Policy Optimization — GSPO)**³ мебошад. Ҳар ду усул ба агентҳо имкон медиҳанд аз бозхӯрди нисбӣ омӯзанд, на аз ҳадафҳои собит. GRPO ба сатҳи токен тамаркуз мекунад, GSPO бошад равандро дар сатҳи пайдарпайӣ такмил медиҳад ва ба агентҳо дар андешаронии самараноки қадам ба қадам ёрӣ мерасонад.
Аз мукофотҳои токенӣ ба омӯзиши пайдарпайиҳо
Бо GRPO ва GSPO омӯзиш, ба як маъно, иҷтимоӣ мешавад. Ҳар траектория дар бораи траекторияҳои дигар ба агент чизе меомӯзонад. Муваффақият ва нокомӣ дигар рӯйдодҳои ҷудогона нестанд; онҳо ба меъёрҳои муқоиса табдил меёбанд. Агент дигар намепурсад: «Оё ман дуруст гуфтам?» Ӯ мепурсад: «Оё ин андешаронӣ аз пештара беҳтар буд?»
Ин гузариш ҳама чизро дигар мекунад. RL аз бозии холгирӣ ба раванди таҳлил табдил меёбад. Агент на танҳо хатоҳоро ислоҳ мекунад, балки меомӯзад, ки дафъаи дигар чӣ гуна беҳтар фикр кунад ва амал намояд.
GRPO
GRPO ба идеяи содае такя мекунад: модел вақте беҳтар меомӯзад, ки ҷавобҳои худро муқоиса карда тавонад. Ба ҷойи баҳодиҳии ҳар ҷавоб бо мукофоти мутлақ, GRPO чанд ҷавоб ба як дархост ҷамъ мекунад, онҳоро дараҷабандӣ менамояд ва аз ин дараҷабандии нисбӣ меомӯзад. Расми 13.3 кори умумии ин равандро нишон медиҳад.
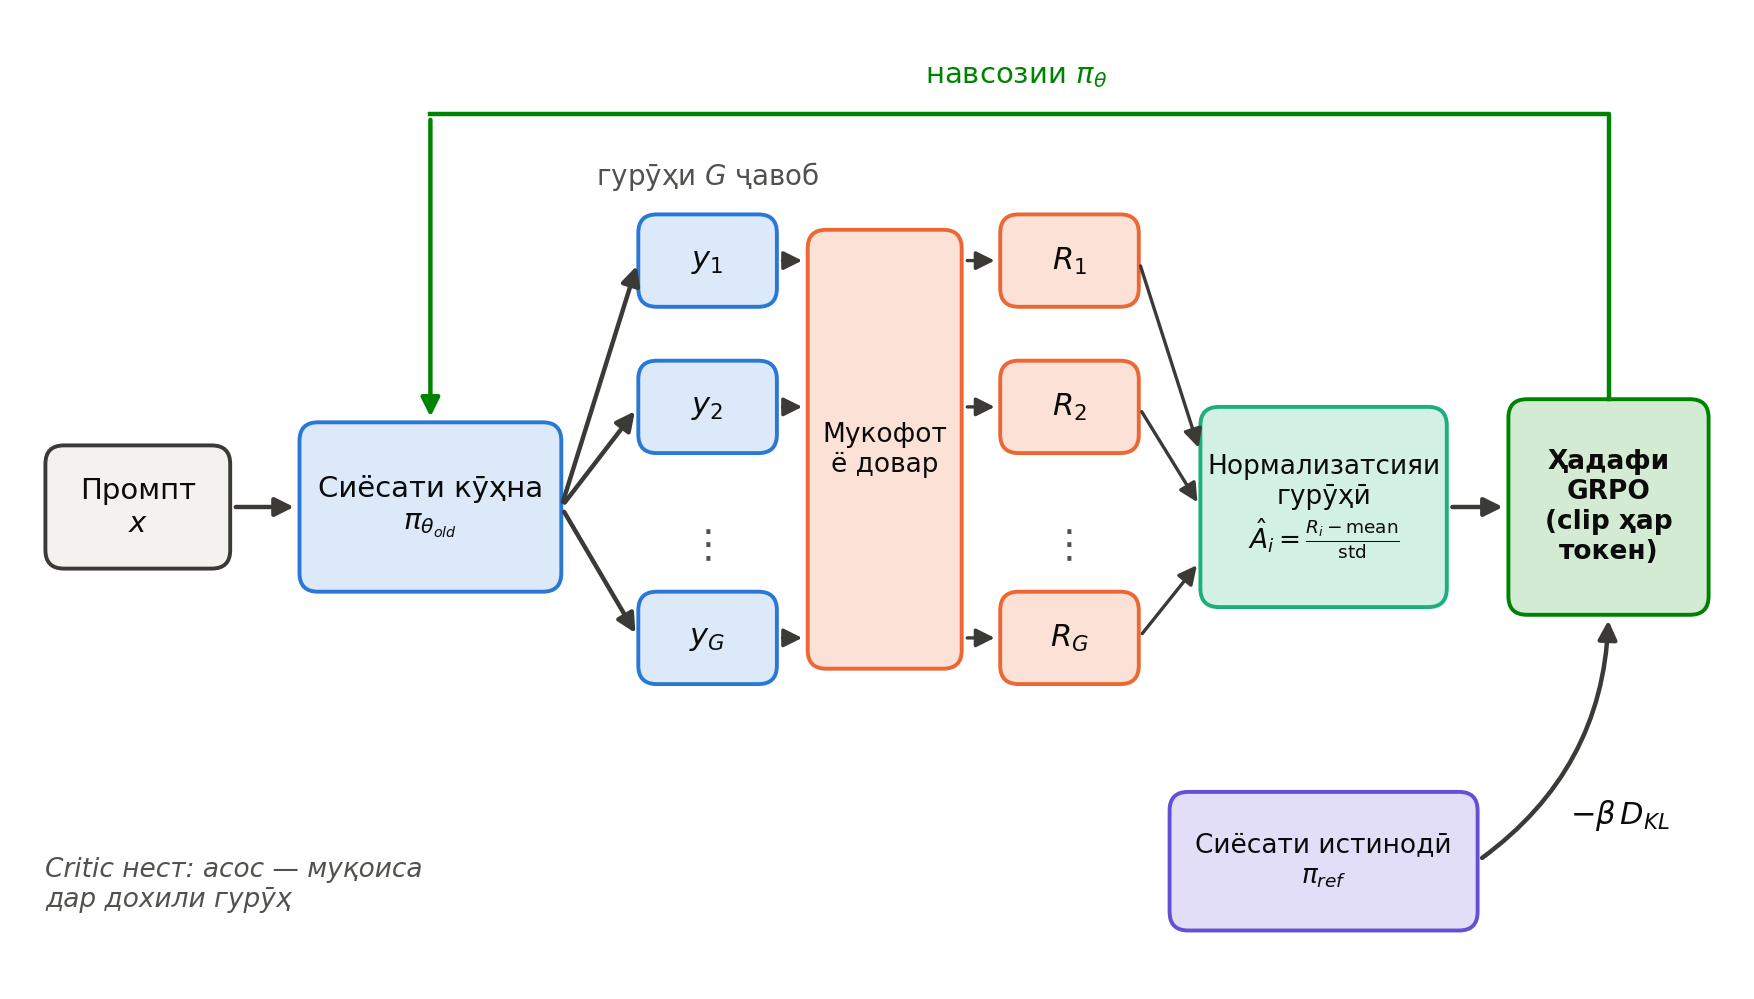
Расми 13.3. Механизми умумии GRPO: мукофотҳои дар дохили гурӯҳ нормализатсияшуда бо ҳади KL нисбат ба сиёсати истинодӣ якҷоя мешаванд.
Раванд аз интихоби промптҳо ва тавлиди чанд ҷавоб тавассути сиёсати ҷорӣ оғоз мешавад. Сипас ҳар ҷавобро функсияи мукофот ё модели довар арзёбӣ карда, ба он холи алоҳида медиҳад. Ин холҳо дар дохили ҳар гурӯҳ нормализатсия мешаванд: қиматҳо марказонида ва миқёсбандӣ мегарданд, то муқоисаҳои нисбӣ ба вуҷуд оянд. Онҳо сигнали навсозии сиёсат мешаванд. Холи ҷавоби (i)-умро бо (R_i) ва шумораи ҷавобҳои гурӯҳро бо (G) ишора мекунем.
Кӣ, чиро ва чӣ гуна меомӯзонад: PPO, DPO, GRPO ва GSPO
Агар мехоҳед бидонед, ки кадом усулҳои маъмули RL ба модели иловагии мукофот ё довар ниёз доранд, ҷадвали 13.3 инро равшан мекунад. Беҳинасозии наздики сиёсат (Proximal Policy Optimization — PPO), ки дар омӯзиш бо тақвият аз бозхӯрди инсон (RLHF) истифода мешавад, модели омӯхташудаи мукофотро бо модели арзёб ё critic якҷоя мекунад, то устуворӣ таъмин ва варианс кам шавад. Беҳинасозии мустақими афзалият (Direct Preference Optimization — DPO) ҳар дуро хориҷ карда, мустақиман аз рӯйи афзалиятҳои ҷуфтӣ ва бо KL-и ошкор нисбат ба сиёсати истинодӣ беҳинасозӣ мекунад. GRPO ба идеяи PPO пайравӣ мекунад, аммо мукофотҳои мутлақро бо дараҷабандии нисбии гурӯҳӣ иваз мекунад. Critic-ро хориҷ карда, буридани нисбатҳо (clipping) ва регуляризатсияи KL-ро нигоҳ медорад. GSPO ин равишро ба сатҳи пайдарпайӣ мебарад, ки устувориро дар натиҷаҳои дароз ё мураккаб беҳтар мекунад.
Ҷадвали 13.3. Кадом усул чӣ кор мекунад?
| Усул | Сиёсати истинодӣ | Мукофот ё довар | Модели critic | Воҳиди беҳинасозӣ |
|---|---|---|---|---|
| PPO (RLHF) | Одатан модели собити бо назорат омӯзонидашуда | Модели мукофоте, ки аз афзалиятҳо омӯзонида шудааст | Бале: сарқисми арзиш ё critic-и алоҳида | Сатҳи токен бо қиматҳои бартарӣ |
| DPO | Сиёсати истинодии собит | Ҳангоми омӯзиш модели мукофоти алоҳида омӯзонида намешавад; афзалиятҳои ҷуфтии инсонӣ истифода мешаванд: интихобшуда ва радшуда | Нест | Сатҳи пайдарпайӣ, функсияи талафоти афзалияти ҷуфтӣ |
| GRPO | Аксаран сиёсати истинодии собит (\pi_{\mathrm{ref}}) | Довар ё функсияи мукофот, одатан LLM ҳамчун довар ё баҳодиҳии барномавӣ барои ҳар намуна | Critic-и омӯхташуда надорад | Сатҳи токен, аммо бартариҳо байни чанд номзад дар гурӯҳ нормализатсия мешаванд |
| GSPO | Аксаран сиёсати истинодии собит (\pi_{\mathrm{ref}}) | Довар ё функсияи мукофот, бо равиши монанд ба GRPO | Нест | Нисбати аҳамият дар сатҳи пайдарпайӣ, бо нормализатсияи гурӯҳӣ |
Ҳар гурӯҳи ҷавобҳо ба як системаи хурди таҷриба табдил меёбад. Модел кори худро мебинад, натиҷаҳоро муқоиса мекунад ва сиёсаташро нав менамояд, то роҳҳои андешаронии баландтар баҳогирифта дафъаи дигар эҳтимоли бештар дошта бошанд. Ин зарурати модели алоҳидаи арзишро аз байн мебарад ва омӯзишро тавассути контексти муштарак устувор мекунад.
Баъдан ҳади дивергенсияи KL байни сиёсати ҷорӣ ва истинодӣ ҳисоб карда мешавад. Пеш аз он муайян мекунем, ки модел чӣ гуна ба ҳар пайдарпайӣ эҳтимол медиҳад. Барои як дархост ва як ҷавоб эҳтимоли пайдарпайӣ чунин таъриф мешавад:
[ \pi_\theta(y \mid x) = \prod_{t=1}^{|y|} \pi_\theta!\left(y_t \mid x,\ y_{<t}\right) ]
Ин ҷо (x) — дархост, (y) — ҷавоб, (y_t) — токени (t)-уми ҷавоб ва (y_{<t}) — токенҳои пеш аз он.
Дар ин ҷо (|y|) шумораи токенҳои ҷавоб аст. Ин ба зарб ҷудо кардани эҳтимол инъикос мекунад, ки модели авторегрессивӣ ҳар токени навбатиро бо назардошти тамоми токенҳои пешина пешгӯӣ мекунад.
Сипас дивергенсияи KL чен мекунад, ки сиёсати навшуда аз сиёсати истинодӣ чӣ қадар дур шудааст:
[ D_{\mathrm{KL}}!\left(\pi_\theta ,|, \pi_{\mathrm{ref}}\right) = \mathbb{E}{y \sim \pi\theta(\cdot \mid x)}!\left[\log \frac{\pi_\theta(y \mid x)}{\pi_{\mathrm{ref}}(y \mid x)}\right] ]
Дар амал ин ҳади KL ҳамчун регуляризатор кор мекунад: моделро барои аз сиёсати истинодӣ хеле дур шудан ҷарима мекунад, аммо ҳамзамон такмили маънодорро иҷозат медиҳад. Онро метавон ҳамчун тасмае дид, ки сиёсатро ҳангоми омӯзиш устувор нигоҳ медорад. Акнун мукофотҳои гурӯҳӣ ва ҷаримаи KL дар ҳадафи GRPO якҷоя мешаванд. Барои ҳар дархост модел аз сиёсати кӯҳна гурӯҳи ҷавобҳоро намунагирӣ мекунад. Ҳар ҷавоб нисбати аҳамият дар сатҳи токенро медиҳад. Ин нисбат нишон медиҳад, ки сиёсати нав ҳамон токенро нисбат ба сиёсати кӯҳна бо эҳтимоли чӣ қадар бештар ё камтар тавлид мекунад:
[ r_{i,t}(\theta) = \frac{\pi_\theta!\left(y_{i,t} \mid x,\ y_{i,<t}\right)}{\pi_{\theta_{\mathrm{old}}}!\left(y_{i,t} \mid x,\ y_{i,<t}\right)} ]
Мукофоти ҳар ҷавоб дар дохили гурӯҳ нормализатсия мешавад ва бартарии нисбиро медиҳад:
[ \hat{A}_i = \frac{R_i - \operatorname{mean}\left({R_1, \dots, R_G}\right)}{\operatorname{std}\left({R_1, \dots, R_G}\right)} ]
Бо ин унсурҳо ҳадафи GRPO чунин мешавад:
[ \mathcal{J}{\mathrm{GRPO}}(\theta) = \mathbb{E}!\left[\frac{1}{G}\sum{i=1}^{G}\frac{1}{|y_i|}\sum_{t=1}^{|y_i|} \min!\Big(r_{i,t}(\theta),\hat{A}i,\ \operatorname{clip}\big(r{i,t}(\theta),,1-\varepsilon,,1+\varepsilon\big),\hat{A}_i\Big)\right]
- \beta, D_{\mathrm{KL}}!\left(\pi_\theta ,|, \pi_{\mathrm{ref}}\right) ]
Ин ҷо (\varepsilon) ҳудуди буридан (одатан тақрибан 0,2) ва (\beta) вазни ҷаримаи KL аст.
Ин муодила ғояи асосии GRPO-ро ба забони математика ифода мекунад. Ҷадвали 13.4 шарҳи мафҳумии GRPO-ро медиҳад.
Ҷадвали 13.4. Ҳадафи GRPO: ҳар қисм чӣ кор мекунад?
| Унсур | Маъно | Аҳамият барои агентҳо |
|---|---|---|
| (r_{i,t}(\theta),\hat{A}_i) | Моделро ташвиқ мекунад, ки эҳтимоли ҷавобҳои баландтар дараҷабандишударо зиёд кунад | Омӯзишро дар ҳар гурӯҳ ба сӯйи роҳҳои беҳтари андешаронӣ мебарад |
| Буридан (Clipping): (\operatorname{clip}(r_{i,t}, 1-\varepsilon, 1+\varepsilon)) | Вақте сиёсати нав аз кӯҳна аз ҳад дур мешавад, навсозии калонро пешгирӣ мекунад | Ҷаҳишҳои калонеро маҳдуд мекунад, ки метавонанд ба фурӯпошии омӯзиш оварда расонанд |
| (\beta, D_{\mathrm{KL}}(\pi_\theta ,\Vert, \pi_{\mathrm{ref}})) | Моделро барои аз сиёсати истинодӣ хеле дур шудан ҷарима мекунад | Ҷустуҷӯро маҳдуд карда, такмил ва устувориро дар тавозун нигоҳ медорад |
Ин нормализатсияи гурӯҳӣ ҳар навсозиро ба контексти маҳаллии худ пайваста, омӯзишро устувор мекунад. Чунонки дар бахши «Омӯзиш бо маҳдудият: дивергенсияи KL» омӯхтед, KL сиёсатро маҳдуд мекунад, то дуршавии аз ҳад зиёд аз сиёсате, ки ҳамчун истинод истифода мешавад, такмилро ба ноустуворӣ набарад.
Дар амал GRPO дар сатҳи токен кор мекунад. Буридан ва ҷаримаи KL ҳангоми тавлиди ҳар токен тадриҷан татбиқ мешаванд. Ҳамин тавр, сигнали омӯзиш ҳам мутобиқшаванда ва ҳам самаранок мемонад.
Қувваи GRPO дар содагии он аст: модели critic надорад, миқёсбандии дастии мукофот надорад, танҳо муқоисаи нисбӣ дар дохили гурӯҳ аст. Ин тарҳ GRPO-ро ба яке аз аввалин усулҳои RL табдил дод, ки моделҳои забониро боэътимод миқёсбандӣ мекард; баъдан GSPO онро боз такмил дод.
GSPO
GSPO принсипҳои GRPO-ро пештар мебарад ва тарзи тафсир ва беҳинасозии таҷрибаи моделро такмил медиҳад. Дар ҳоле ки GRPO андешарониро дар сатҳи токен арзёбӣ мекунад, GSPO як сатҳ боло рафта, тамоми пайдарпайиҳоро ҳамчун воҳид беҳина мекунад. Расми 13.4 механизмҳои умумии GSPO-ро нишон медиҳад.
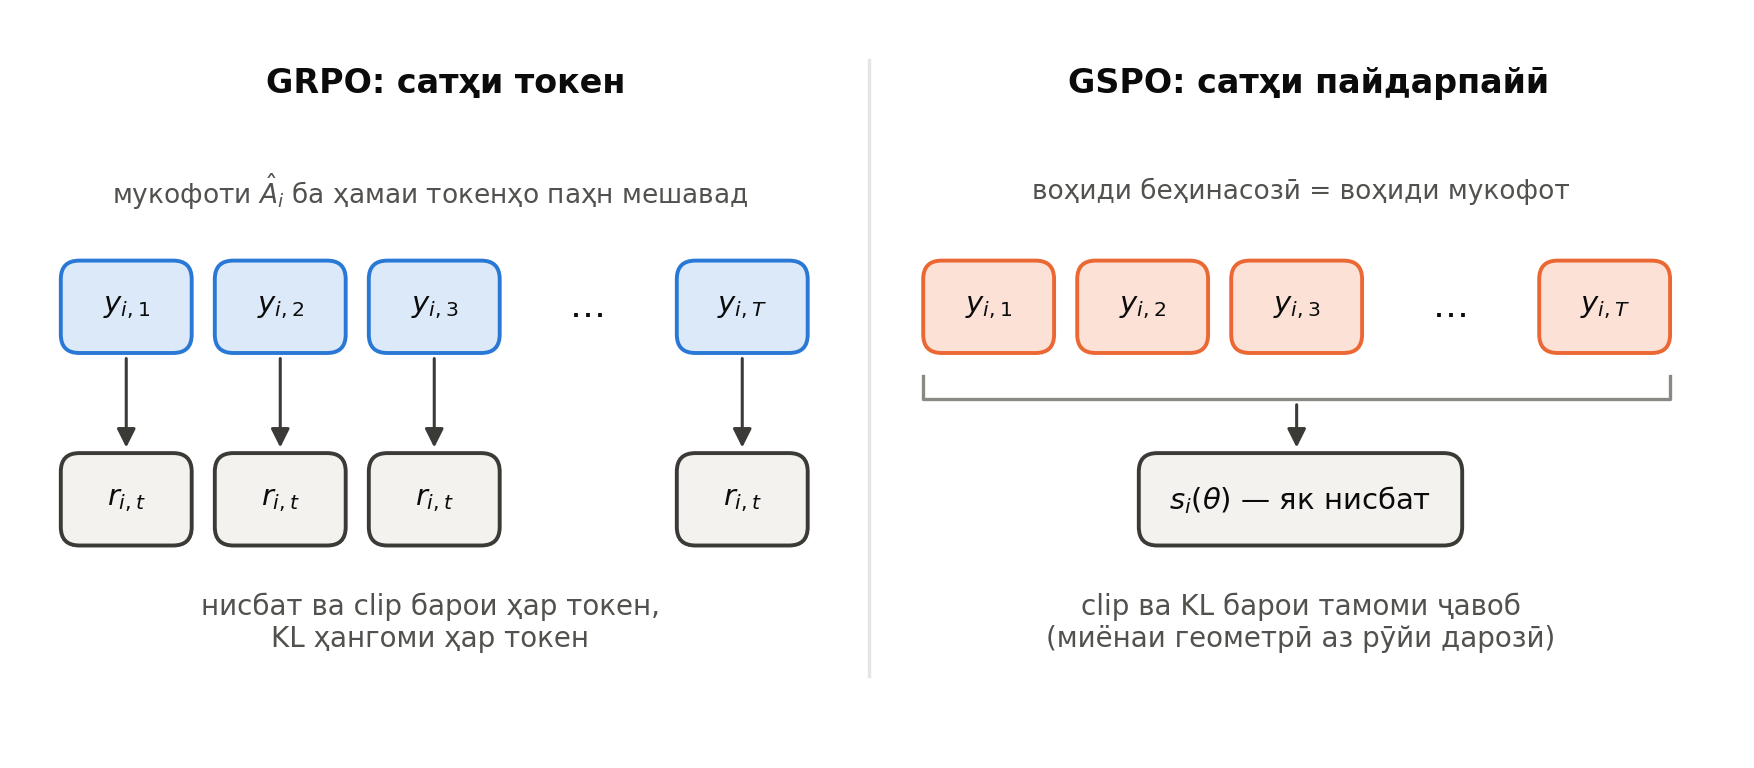
Расми 13.4. Бар хилофи GRPO, ки дар сатҳи токен арзёбӣ мекунад, GSPO мукофотҳо ва дивергенсияи KL-ро дар тамоми пайдарпайиҳо ҳисоб мекунад.
Сабаби GSPO сода аст: мукофот ба тамоми пайдарпайӣ тааллуқ дорад, на ба токенҳои алоҳида. Агар модел барои тамоми ҷавоб бозхӯрд гирад, беҳинасозӣ низ бояд дар ҳамин миқёс сурат гирад. Бо гузарондани сигнали омӯзиш аз токенҳо ба пайдарпайиҳо, GSPO воҳиди беҳинасозиро бо воҳиди мукофот мувофиқ мекунад.
Мисли пештара, модел аз дархост ва маҷмӯи ҷавобҳое оғоз мекунад, ки аз сиёсати кӯҳна намунагирӣ шудаанд. Аммо акнун ба ҷойи нисбатҳои эҳтимол дар сатҳи токен, GSPO дуршавии сиёсати нав аз кӯҳнаро дар тамоми ҷавоб чен мекунад. Ин нисбати аҳамият дар сатҳи пайдарпайӣ чунин таъриф мешавад:
[ s_i(\theta) = \left(\frac{\pi_\theta(y_i \mid x)}{\pi_{\theta_{\mathrm{old}}}(y_i \mid x)}\right)^{\frac{1}{|y_i|}} = \exp!\left(\frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \log \frac{\pi_\theta!\left(y_{i,t} \mid x,\ y_{i,<t}\right)}{\pi_{\theta_{\mathrm{old}}}!\left(y_{i,t} \mid x,\ y_{i,<t}\right)}\right) ]
(|y_i|) дар ин ҷо шумораи токенҳои ҷавобро ифода мекунад. Нормализатсия аз рӯйи дарозӣ нисбатро аз ҷиҳати ададӣ устувор нигоҳ медорад ва пешгирӣ мекунад, ки ҷавобҳои дароз навсозиҳои номутаносибан калон ба вуҷуд оранд.
Бартарии гурӯҳӣ мисли GRPO мемонад ва чунин ҳисоб мешавад:
[ \hat{A}_i = \frac{R_i - \operatorname{mean}\left({R_1, \dots, R_G}\right)}{\operatorname{std}\left({R_1, \dots, R_G}\right)} ]
Бо ин таърифҳо ҳадафи GSPO чунин мешавад:
[ \mathcal{J}{\mathrm{GSPO}}(\theta) = \mathbb{E}!\left[\frac{1}{G}\sum{i=1}^{G} \min!\Big(s_i(\theta),\hat{A}_i,\ \operatorname{clip}\big(s_i(\theta),,1-\varepsilon,,1+\varepsilon\big),\hat{A}_i\Big)\right] ]
Ин ҳадаф ҳамон мантиқи GRPO-ро пайравӣ мекунад, аммо навсозиро ба тамоми пайдарпайӣ татбиқ менамояд, на ба ҳар токен. Ҳамин тавр, вариансеро бартараф мекунад, ки ҳангоми тағйир ёфтани мустақилонаи вазнҳои аҳамияти токенҳо дар ҷавобҳои дароз ҷамъ шуда метавонад.
Дар амалисозиҳо аксаран ҷаримаи KL дар сатҳи пайдарпайӣ низ, монанди GRPO, дохил мешавад. Агар он хориҷ карда шавад, қатъи барвақт ва нормализатсияи гурӯҳӣ ҳамоно омӯзишро устувор мекунанд. Ҷадвали 13.5 ҷузъҳои асосии GSPO-ро нишон медиҳад.
Ҷадвали 13.5. Ҳадафи GSPO: ҳар қисм чӣ кор мекунад?
| Унсур | Маъно | Аҳамият барои агентҳо |
|---|---|---|
| (s_i(\theta),\hat{A}_i) | Моделро ба афзал донистани ҷавобҳои пурраи дорои мукофоти нисбии баланд ташвиқ мекунад | Омӯзишро бо иҷрои тамоми пайдарпайӣ мувофиқ мекунад, на бо ислоҳҳои токен ба токен |
| Буридан (Clipping): (\operatorname{clip}(s_i, 1-\varepsilon, 1+\varepsilon)) | Вақте сиёсати нав аз кӯҳна хеле фарқ мекунад, навсозии аз ҳад калонро маҳдуд менамояд | Ноустувориро кам мекунад ва аз таркиши градиент дар ҷавобҳои дароз пешгирӣ мекунад |
| Нормализатсия аз рӯйи дарозӣ: дараҷаи (1/\lvert y_i \rvert) | Навсозиҳоро мувофиқи дарозии ҷавоб миқёсбандӣ мекунад | Омӯзишро барои ҷавобҳои кӯтоҳу дароз ҳамоҳанг нигоҳ медорад |
Ин гузариш аз беҳинасозии токенӣ ба беҳинасозии пайдарпайӣ таъсири амиқ дорад. Он ноустувориеро бартараф мекунад, ки аз садои ислоҳҳои токенӣ, махсусан дар ҷавобҳои дароз ё моделҳои хеле калон, пайдо шуда метавонад. Бо буридан ва мукофот додан ба ҷавобҳои пурра ба ҷойи токенҳои алоҳида, GSPO омӯзишро ҳамвортар, боэътимодтар ва ба тарзи таъйини воқеии мукофотҳо мувофиқтар мекунад.
Он ҳамчунин зерсохтори омӯзиш бо тақвиятро сода мегардонад. Азбаски GSPO бо эҳтимоли пайдарпайиҳо кор мекунад, аксаран метавонад эҳтимолҳои ҳангоми инференс ҳисобшударо дубора истифода барад, ба ҷойи он ки ҳангоми омӯзиш эҳтимолҳои токениро аз нав ҳисоб кунад. Ин онро ҳам аз ҷиҳати ҳисоббарорӣ самаранок ва ҳам дар системаҳои калонмиқёс устувор мегардонад. Ҷадвали 13.6 ду усулро муқоиса мекунад.
Ҷадвали 13.6. Муқоисаи GRPO ва GSPO
| Ҷиҳат | GRPO | GSPO |
|---|---|---|
| Сигнали омӯзиш | Аз дараҷабандии нисбии чанд ҷавоб ба як дархост меомӯзад | Аз муқоисаҳо дар сатҳи пайдарпайӣ меомӯзад; ҳар ҷавоби пурраро бо эҳтимоли умумии он вазн медиҳад |
| Сатҳи беҳинасозӣ | Навсозии токенҳо дар дохили ҳар ҷавоб | Навсозӣ дар сатҳи тамоми пайдарпайии ҷавоб |
| Ҷузъиёти мукофот | Бартарии якхела барои токенҳо истифода мешавад, аммо нисбатҳои аҳамият барои ҳар токен ҳисоб мешаванд | Бартарӣ барои ҳар пайдарпайӣ ҳисоб мешавад ва нисбатҳои аҳамият ба ҳамаи токенҳо яксон татбиқ мешаванд |
| Устуворӣ | Ба ҷамъшавии садо дар ҷавобҳои дароз ҳассос аст; дар моделҳои хеле калон ё омехтаи коршиносон (MoE) метавонад ноустувор шавад | Ба таври назаррас устувортар аст; аз варианс дар сатҳи токен ва фурӯпошии модел пешгирӣ мекунад |
| Механизми буридан | Нисбатҳои аҳамиятро барои ҳар токен маҳдуд мекунад, то дуршавии калони off-policy пешгирӣ шавад | Тамоми пайдарпайиҳоро маҳдуд карда, миқёси мукофот ва беҳинасозиро мувофиқ мекунад |
| Самаранокӣ | Ҳангоми омӯзиш эҳтимолҳои токенҳоро зуд-зуд аз нав ҳисоб кардан лозим аст | Метавонад эҳтимолҳои пайдарпайиро аз инференс дубора истифода барад ва ҳисоббарориро самараноктар кунад |
| Мураккабии зерсохтор | Барои устувории MoE ба ивазкунандаҳои модели арзиш ё такрори масирдиҳӣ ниёз дорад | Зарурати стратегияҳои иловагии устуворсозиро бартараф карда, омӯзиши RL-и калонмиқёсро сода мекунад |
| Таъсири амалӣ | Таҳлил ва омӯзиш аз муқоисаро имконпазир мекунад, аммо ҳангоми миқёсбандӣ метавонад мушкил дошта бошад | Ба моделҳои хеле калон боэътимод миқёс мешавад ва меъмориҳои муосир, аз ҷумла Qwen3 ва системаҳои MoE-ро дастгирӣ мекунад |
GRPO ва GSPO якҷоя нишон медиҳанд, ки агентҳо метавонанд на аз ҷавобҳои ошкор, балки аз арзёбии худ омӯзанд. GRPO ба агент муқоисаи натиҷаҳо ва омӯзиш аз муваффақияти нисбӣ дар сатҳи токенро меомӯзонад. GSPO бошад GRPO-ро бо беҳинасозии пайдарпайиҳои гурӯҳии сиёсат дар сатҳи пайдарпайӣ такмил медиҳад. Арзёбӣ аз санҷиши қисмҳои ҷавоб ба санҷиши тамоми пайдарпайӣ таҳти сиёсат мегузарад. Дар ин марҳила агент ҷузъҳои асосии худтакмилдиҳиро дорад: метавонад арзёбӣ, муқоиса ва такмил кунад. Вазифаи навбатӣ ин аст, ки ба ӯ истифодаи низомноки ин принсипҳоро омӯзонед ва таҷрибаҳои парокандаро ба траекторияҳои сохторёфта табдил диҳед, ки барои рушди минбаъда дубора истифода мешаванд.
Бе чархҳои ёрирасон: ба агентҳо чӣ гуна омӯхтанро ёд медиҳем
То ин ҷо агенти шумо чизҳои зиёдеро дидааст. Вобаста ба модели забонии асосӣ, шояд аллакай таҷриба ҷамъ карда, роҳҳои андешаронии худро муқоиса намуда ва фарқ кардани қарорҳои хуб аз бадро омӯхта бошад. Аммо танҳо таҷрибаи умумӣ системаро барои вазифаҳои махсуси шумо боэътимод намекунад. Муҳим он аст, ки чӣ гуна ба агент малакаи нав омӯзонед ё малакаи аллакай омӯхтаашро беҳтар кунед. Ин бахш ба ҳамин масъала бахшида шудааст.
Агар агентро ҳамчун омӯзанда тасаввур кунед, истифодаи RL барои омӯзондани малакаи нав ҳамон лаҳзаест, ки чархҳои ёрирасони дучарха гирифта мешаванд. Ҳар калавиш, ислоҳ ва ҳаракат ба пеш қисми сиёсати таҳаввулёбандаи он мешавад. Бале, агент метавонад калавида, афтад ва худро ислоҳ кунад, аммо омӯзиши воқеӣ ҳамин тавр оғоз меёбад.
Тавассути чаҳорчӯбаҳое чун ART ва RULER, агент аз ҳалқаҳои сохторёфтаи бозхӯрд такмил додани худро меомӯзад. ART чаҳорчӯбаи кушодаасосест, ки барои омӯзондани LLM-ҳои агентӣ тавассути rollout-ҳои сохторёфта тарҳрезӣ шудааст. Диққати он ба истифодаи абзор ва қароргирӣ равона аст. ART бо такя ба GRPO ва омӯзиш аз таҷриба иҷро ва эътимоднокии агентро беҳтар мекунад. RULER ин равишро ҳамчун функсияи умумии мукофот пурра менамояд: он LLM-ро ҳамчун довар истифода мебарад, то траекторияҳои агентро аз рӯйи сифат дараҷабандӣ карда, бе нишондиҳандаҳои дастӣ бозхӯрди пайгирона диҳад.
ART ва RULER якҷоя ба шумо ёрӣ медиҳанд, ки агентҳоро танҳо аз рӯйи тавсифи вазифа ба сӯйи натиҷаи хуб роҳнамоӣ кунед, бе зарурати ҷавобҳои интизоршаванда. Натиҷа на танҳо агентест, ки вазифаҳоро иҷро мекунад, балки агентест, ки дар доираи контекст ва ҳангоми ҳамкорӣ бо агентҳои дигар фаҳмиши амиқтаре аз тарзи беҳтар кардани худ пайдо мекунад.
Фаротар аз арзёбии ҷудогона: чаро муқоисаи нисбӣ осонтар аст
Тарҳрезии мукофот пештар яке аз душвортарин қисмҳои RL буд. Функсияҳои махсуси мукофот аксаран ҳангоми тағйир ё миқёсбандии вазифаҳо корношоям мешуданд. Системаҳои LLM ҳамчун довар мебоист инро ҳал кунанд, аммо кӯшишҳои аввал бо холҳои номувофиқ ва калибркунии пур аз садо мушкил доштанд. RULER бо гузариш аз баҳодиҳии мутлақ ба муқоисаи нисбӣ ин мушкилро кам мекунад. Илова бар ин, чунонки медонед, GRPO ва GSPO холҳоро дар дохили ҳар гурӯҳ нормализатсия мекунанд. Аз ин рӯ, дараҷабандии нисбӣ муҳим аст, на қиматҳои мутлақ.
RULER барои як вазифа чанд траектория тавлид мекунад. Ҳар траектория андешаронӣ, даъватҳои абзор ва натиҷаи ниҳоии агентро сабт мекунад. Оғозҳои муштарак хориҷ мешаванд ва танҳо қисмҳои фарқкунанда бо як меъёрномаи сода ба LLM-довар фиристода мешаванд. Довар ба ҳар траектория аз 0 то 1 хол медиҳад, вобаста ба он ки ҳадафи вазифаро чӣ қадар хуб иҷро кардааст. Ин холҳо дар дохили гурӯҳ нормализатсия мешаванд ва мустақиман ҳамчун мукофот барои навсозии GRPO истифода мегарданд. Довар метавонад қарорҳояшро ҳам шарҳ диҳад. Ин ба пайгирии хатоҳо ва гурӯҳбандии иҷроҳои суст ёрӣ мерасонад. Расми 13.5 пайвастшавии ин равандҳоро нишон медиҳад.
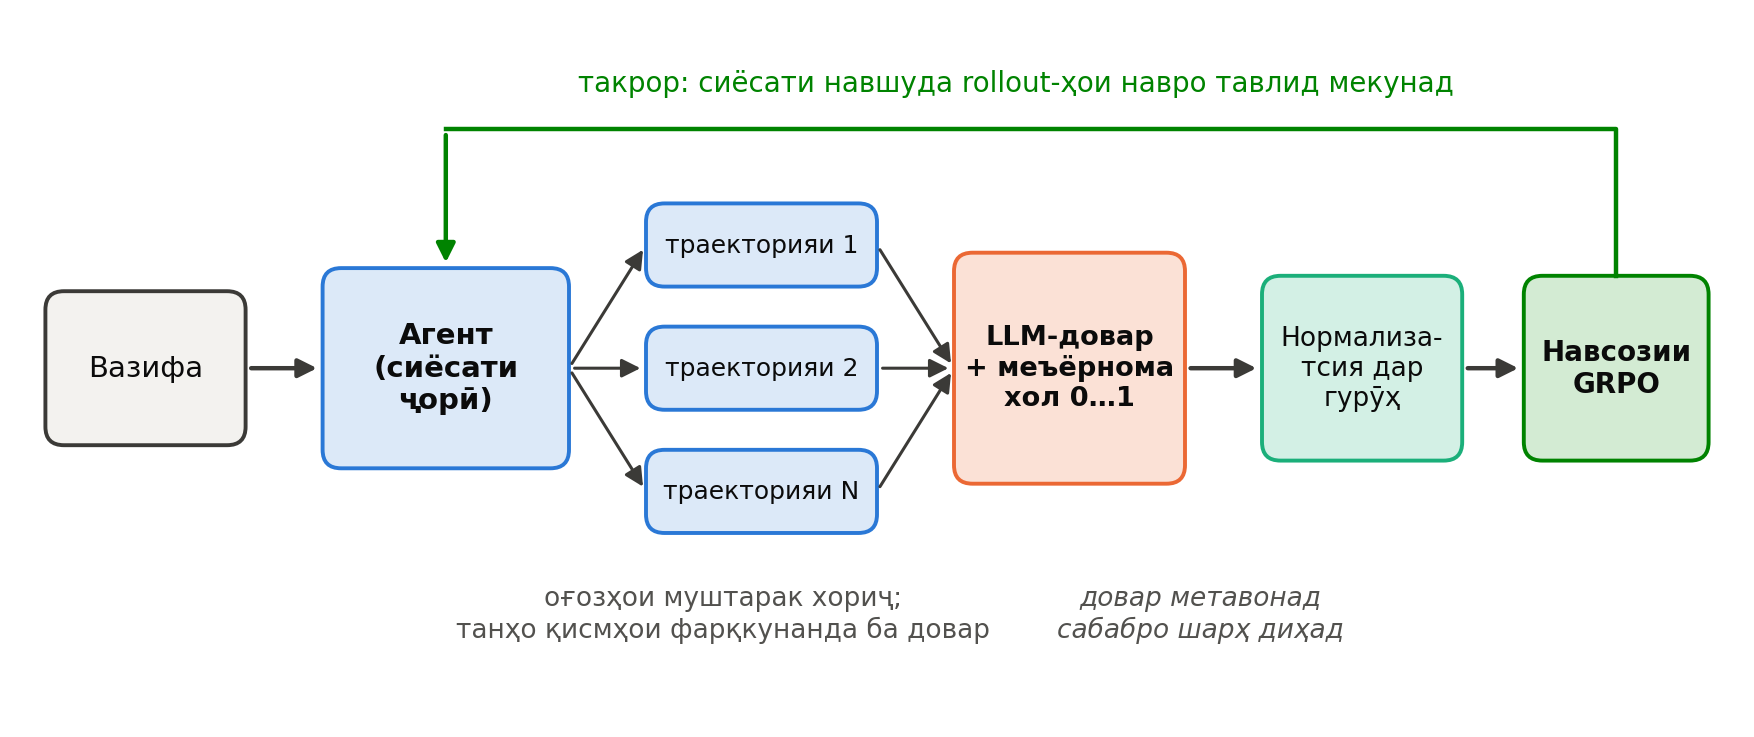
Расми 13.5. Ҳалқаи омӯзиши RULER: траекторияҳо тавассути LLM-довар дараҷабандӣ мешаванд, бо GRPO нормализатсия мегарданд ва барои навсозии такрории сиёсат истифода мешаванд.
Барои фаҳмидани содагии RULER як мисоли мушаххаси барномасозӣ меорем. Тасаввур кунед, мехоҳед шеърҳои кӯтоҳ дар бораи гурбаҳоро арзёбӣ кунед. Аввал паёмҳои LLM-ро омода мекунед, чунонки дар намунаи 13.1 нишон дода шудааст.
Намунаи 13.1. Омодасозии паёмҳои муштарак
initial_messages = [
        {"role": "system", "content": """You are a poetic writer. Write short
                                      cat-themed poems that evoke emotion."""},
        {"role": "user", "content": """Write a poem about cats observing the
                                    sky."""}
    ]
Қадами навбатӣ сохтани чанд траекторияи намунавӣ бо сифати гуногун аст. Намунаи 13.2 маҷмӯи траекторияҳои сохтаро муайян мекунад: аз шеъри хуб то ҷавоби берун аз мавзӯъ. Дар иҷрои воқеии RULER худи агент ин натиҷаҳоро тавлид мекард. Дар ин ҷо онҳо пешакӣ дода шудаанд, то раванди баҳодиҳиро равшан бинед.
Намунаи 13.2. Сохтани траекторияҳо бо сатҳҳои гуногуни сифат
good_trajectory = art.Trajectory(
    messages_and_choices=[
        *initial_messages,
        Choice(
            finish_reason="stop",
            index=0,
            message=ChatCompletionMessage(
                role="assistant",
                content=(
                    "Upon the roof, their eyes like stars,\n"
                    "They watch the sky from silver jars.\n"
                    "Each whisker twitches, soft delight,\n"
                    "As moons reflect their borrowed light."
                )
            )
        )
    ],
    reward=0.0
)

mediocre_trajectory = art.Trajectory(
    messages_and_choices=[
        *initial_messages,
        Choice(
            finish_reason="stop",
            index=0,
            message=ChatCompletionMessage(
                role="assistant",
                content=(
                    "Cats sit and look at stars at night,\n"
                    "They think the stars are shiny and bright."
                )
            )
        )
    ],
    reward=0.0
)

off_topic_trajectory = art.Trajectory(
    messages_and_choices=[
        *initial_messages,
        Choice(
            finish_reason="stop",
            index=0,
            message=ChatCompletionMessage(
                role="assistant",
                content=(
                    "Dogs are great companions under the moon. "
                    "They bark at stars and wag their tails happily."
                )
            )
        )
    ],
    reward=0.0
)
Пас аз тавлиди траекторияҳо, намунаи 13.3 онҳоро ҳамчун гурӯҳ бо RULER арзёбӣ мекунад. RULER вазифаи функсияи баҳодиҳиро иҷро мекунад; модели довар траекторияҳои номзадро муқоиса карда, хол медиҳад. Сипас холҳо ва шарҳҳои баргардондашударо барои дараҷабандии траекторияҳо истифода бурдан мумкин аст.
Намунаи 13.3. Баҳодиҳӣ бо RULER
group = art.TrajectoryGroup([good_trajectory, mediocre_trajectory,
                            off_topic_trajectory])
judged_group = await ruler_score_group(group, "openai/o3", debug=True)
Пас аз арзёбии гурӯҳ, намунаи 13.4 мукофотҳои баргардондаи RULER-ро мегирад ва рӯйхати мураттаби натиҷаҳоро чоп мекунад. Ҳамин тавр, муқоисаи баҳои модели довар ба ҳар шеър осон мешавад.
Намунаи 13.4. Намоиши дараҷабандии траекторияҳо
if judged_group:
        sorted_trajectories = sorted(judged_group.trajectories,
                                key=lambda t: t.reward, reverse=True)
        for rank, traj in enumerate(sorted_trajectories, 1):
            messages = traj.messages()
            print(f"Rank {rank}: Score {traj.reward:.3f}")
            print(f"  Response: {messages[-1]['content'][:80]}...\n")
Натиҷаи маъмул чунин менамояд:
[RULER] Pretty-printed LLM choice JSON:
{
    'scores': [
        {
            'trajectory_id': '1',
            'explanation': 'Poetic, cat-focused, night-sky theme fulfilled with
                            vivid imagery; brief and compliant.',
            'score': 0.9
        },
        {
            'trajectory_id': '2',
            'explanation': 'Meets topic but very simplistic and minimally
                            evocative; partial fulfillment.',
            'score': 0.6
        },
        {
            'trajectory_id': '3',
            'explanation': 'Ignores cat theme, focuses on dogs; fails the
                            main instruction.',
            'score': 0.05
        }
    ]
}
Маънои шарҳҳои довар:
- Траекторияи 1 — 0,9: шеърӣ аст, ба гурбаҳо тамаркуз мекунад ва мавзӯи осмони шабро бо тасвирҳои равшан ифода менамояд; кӯтоҳ ва мувофиқи дастур аст.
- Траекторияи 2 — 0,6: ба мавзӯъ мувофиқ аст, аммо хеле сода буда, эҳсосро кам бармеангезад; вазифа қисман иҷро шудааст.
- Траекторияи 3 — 0,05: мавзӯи гурбаҳоро нодида гирифта, ба сагҳо тамаркуз мекунад; дастури асосӣ иҷро нашудааст.
Сабабҳои кор кардани ин равиш:
- Барои модели забонӣ муқоисаи чанд номзад осонтар аз баҳои ҷудогона додан ба як номзад аст. Вақте вариантҳо паҳлуи ҳаманд, фарқҳо равшан мешаванд.
- Ба GRPO танҳо мукофотҳое лозиманд, ки дар дохили гурӯҳ пайгирона бошанд. Калибркунии умумӣ лозим нест; ин омӯзишро устувор ва миқёспазир нигоҳ медорад.
Дар амал ин тарҳ зарурати додаҳои тамғагузоришуда ё қоидаҳои дастиро аз байн мебарад. Он ҳамчунин расидан ба натиҷаи устуворро тез мекунад, зеро беҳбудиҳои қисман низ мувофиқи саҳмашон мукофот мегиранд. Дар натиҷа сигнали мукофоте ҳосил мешавад, ки худислоҳшаванда, фаҳмопазир ва самаранок аст.
Аз ин мисол равшан мебинед, ки RULER чӣ гуна дар баҳодиҳии вазифаҳои матнӣ ва дигар вазифаҳои кушода ёрӣ медиҳад: шарҳҳо, занҷираҳои андешаронӣ, хулосаҳо, эссеҳо, муошират бо муштариён ва таҳлили илмӣ. Сифат дар ин ҳолатҳо аз равшанӣ, пуррагӣ, умқи мулоҳиза, оҳанг ва эҷодкорӣ вобаста аст. Ҳеҷ яке аз инҳоро ба як формула маҳдуд кардан мумкин нест. RULER чанд траекторияро тавассути модел нисбатан муқоиса мекунад, то LLM-довар фарқҳои нозукро дараҷабандӣ намояд: ҷараёни ҳамоҳангтари андешаронӣ, галлюсинатсияҳои камтар ва мантиқи равшантар.
Барои масъалаҳои муайян, аз ҷумла вазифаҳои Countdown, ки ҳадафашон расидан ба адади мушаххас бо маҷмӯи собити ададҳо ва амалҳои арифметикӣ аст, мукофотро метавон барномавӣ таъриф кард. Мукофоти қоидавӣ дар ин ҷо хуб кор мекунад, зеро дурустӣ дуҳолата аст ва онро худкор санҷидан мумкин аст.
Аммо вақте системаро бо андешаронии тавзеҳӣ ё таҳлилӣ васеъ мекунед, агент бояд шарҳ диҳад, ки чӣ гуна ба ифодаи дуруст расидааст ё ҳар амалро асоснок кунад. Дар ин ҳолат меъёрҳои арзёбӣ нозуктар мешаванд. Метавон мукофоти омехта ҷорӣ кард. Ин механизм дақиқии санҷиши муайяни дурустиро бо арзёбии сифатии RULER якҷоя мекунад: танҳо ҳалли математикии дуруст хол мегирад, аммо сифати андешаронӣ, сохтор ва равшании он ҳам ба мукофоти ниҳоӣ таъсир мерасонанд.
Ин мафҳум бо андешаронии ададӣ маҳдуд нест. Мукофоти омехтаро ба агентҳои коднавис низ татбиқ кардан мумкин аст: дурустии функсионалӣ барномавӣ санҷида мешавад, аммо услуб, хонданбобӣ ва сифати ҳуҷҷатгузорӣ метавонанд арзёбии модели забониро талаб кунанд. Онро ба вазифаҳои тавлиди матн низ васеъ кардан мумкин аст: ченакҳои объективӣ, аз ҷумла дурустии далелҳо ё риояи маҳдудиятҳо, ба холҳои скалярии дурустӣ табдил ёфта, бо арзёбии услуби RULER якҷоя мешаванд.
Дар моҳият, мукофоти омехта роҳи осони якҷоя кардани санҷиши рамзӣ ва арзёбии забонӣ аст. Он функсияҳои мукофот месозад, ки дақиқӣ ва фаҳмопазириро дар тавозун нигоҳ медоранд. Бахши «ART-и омӯзиш аз таҷриба» нишон медиҳад, ки инро бо ART ва GRPO барои омӯзондани агенти ҳалкунандаи Countdown чӣ гуна амалӣ кардан мумкин аст.
ART-и омӯзиш аз таҷриба
Акнун, ки кори RULER-ро медонед, омодаед агентро ба марҳилаи нав баред: барои вазифа воқеан траекторияҳо тавлид кунед ва бо ART ба беҳтаршавии он ёрӣ расонед. Дар мисоли навбатӣ ба агент ҳалли масъалаҳои математикии Countdown-ро бо мукофоти омехта меомӯзонед. Ин тарҳ мукофоти муайян барои дурустии ададиро бо баҳодиҳии RULER барои сифати андешаронӣ якҷоя мекунад. Ҳамин тавр, агент ҳам дақиқӣ ва ҳам равшаниро меомӯзад.
Эзоҳ. Дар ин ҷо мо ба қисмҳои асосии код диққат медиҳем ва барои равшан нишон додани мантиқи марказӣ функсияҳои ёрирасон ё бахшҳои хурдро намеорем. Коди пурраи иҷрошаванда дар анбори китоби аслӣ дастрас аст.
Аввал маҷмӯи додаҳо, ки дар ин ҷо нишон дода нашудааст, ва модели омӯзишпазирро (намунаи 13.5) бо backend-и маҳаллӣ (намунаи 13.6) омода мекунед.
Намунаи 13.5. Омодасозии модел ва танзимоти он
model = art.TrainableModel(
    name="countdown-agent-001",
    project="countdown-agent",
    base_model="Qwen/Qwen2.5-7B-Instruct",
)
Намунаи 13.6. Омодасозӣ ва сабти backend
backend = LocalBackend(in_process=True, path="./.art")
await model.register(backend)
Баъдан интерфейси вазифаро муайян мекунед: абзорҳои сода барои хондани контексти ҷорӣ, ҷустуҷӯи ифодаи дуруст ва баргардондани ҷавоби ниҳоӣ, то ART траекторияро баҳогузорӣ кунад. Ин қисмро низ наовардаем, аммо дар notebook онро дар бахши «Exact Search Tool with Fractions» — «Абзори ҷустуҷӯи дақиқ бо касрҳо» — меёбед.
Пеш аз иҷрои rollout-ҳо бояд довари барномавӣ барои санҷиши дуҳолатаи дурустӣ илова кунед. Он мукофоти қатъӣ медиҳад, ки ҳалли дақиқро талаб мекунад. Намунаи 13.7 намунаи ҳамин мукофот аст.
Намунаи 13.7. Илова кардани довари муайян барои санҷиши дурустӣ
def judge_countdown_expression(
    target: int,
    allowed_nums: List[int],
    expr: str,
    enforce_integer_intermediates: bool = False,
) -> Tuple[float, Optional[float], Optional[str]]:

    expr = expr.strip()
    if not expr:
        return 0.0, None, "empty expression"
    if re.search(r"[^0-9\+\-\*\/\(\)\.\s]", expr):
        return 0.0, None, "invalid characters"

    used = numbers_used_in_expr(expr)

    def counts(xs):
        d = {}
        for v in xs:
            d[v] = d.get(v, 0) + 1
        return d

    allowed_counts = counts([int(x) for x in allowed_nums])
    used_counts    = counts(used)

    for v, c in used_counts.items():
        if v not in allowed_counts or c > allowed_counts[v]:
            return 0.0, None, f"illegal number usage: {v}"
    try:
        if enforce_integer_intermediates:
            val_frac = _eval_ast_fraction(ast.parse(expr, mode="eval"))
            if val_frac == Fraction(target, 1):
                return 1.0, float(val_frac), None
            return 0.0, float(val_frac), "wrong value"
        else:
            val = safe_eval_expr(expr)
            if abs(val - target) < 1e-9:
                return 1.0, val, None
            return 0.0, val, "wrong value"
    except ZeroDivisionError:
        return 0.0, None, "division by zero"
    except Exception as e:
        return 0.0, None, f"eval error: {e}"
Шарҳи қисмҳои код:
- Аломатҳоро барои бехатарӣ санҷед.
- Истифодаи ададҳоро санҷед.
Дар намунаи 13.8 аз маҷмӯи додаҳо сенарияҳо месозед, то ҳар rollout промпт ва идентификаторҳои равшан дошта бошад.
Намунаи 13.8. Сохтани сенарияҳо
class Scenario(BaseModel):
    id: str
    target: int
    nums: List[int]
    question: str

def mk_scenario(row, idx: int) -> Scenario:
    tgt  = int(row["target"])
    nums = [int(x) for x in row["nums"]]
    q = """Using only the numbers each at most once, write a valid
            arithmetic expression with +, -, *, or / that evaluates
            exactly to the target. Return only the expression string."""

    return Scenario(id=f"cd_{idx}", target=tgt, nums=nums, question=q)

train_scenarios = [mk_scenario(train_ds[i], i) for i in range(len(train_ds))]
test_scenarios  = [mk_scenario(test_ds[i], i)  for i in range(len(test_ds))]
Вақте додаҳо, абзорҳо ва довар омодаанд, метавонед rollout-ро муайян кунед. Намунаи 13.9 як вазифаро аз аввал то охир иҷро мекунад, истифодаи абзорро иҷозат медиҳад, ҷавоби ниҳоиро сабт мекунад ва мукофотҳою нишондиҳандаҳоро барои ART дар траектория менависад.
Намунаи 13.9. Сохтани rollout барои сабти траекторияҳо
class ProjectTrajectory(art.Trajectory):
    final_answer: Optional[FinalAnswer] = None

class CountdownScenario(BaseModel):
    step: int
    scenario: Scenario

@weave.op
async def rollout(model: art.Model, cd: CountdownScenario) -> ProjectTrajectory:
    scn = cd.scenario

    _nonlocal_final["value"] = None
    _current_scenario["target"] = scn.target
    _current_scenario["nums"]   = scn.nums
    _current_scenario["id"]     = scn.id

    nums_str = ",".join(map(str, scn.nums))
    traj = ProjectTrajectory(
        reward=0.0,
        messages_and_choices=[],
        metadata={"scenario_id": scn.id,
                 "target": float(scn.target), "nums": nums_str},
    )
    if traj.metrics is None:
        traj.metrics = {}

    system_prompt = dedent(f"""
        You are a math agent for countdown tasks.

        Goal: produce one expression that evaluates exactly to {scn.target}
        using only the numbers {scn.nums} each at most once.
        Operators: +, -, *, /. Parentheses are allowed.

        Tools:
        - read_countdown_context()
        - countdown_search_tool(nums=[...], target=...,
          require_integer_intermediates=True)
        - return_final_answer_tool(answer=EXPR, reference_ids=[...])

        Process:
        1) Call read_countdown_context to confirm inputs.
        2) Call countdown_search_tool. If it returns a nonempty expression,
           pass it verbatim to return_final_answer_tool.
        3) If it returns empty, reason and still obey number usage.
        The final tool must receive ONLY the expression string.
    """)

    tools = [read_countdown_context, countdown_search_tool, return_final_answer_tool]
    chat  = init_chat_model(model.name, temperature=0.6, top_p=0.9, max_tokens=256)
    agent = create_react_agent(chat, tools)

    try:
        config = {"configurable": {"thread_id": str(uuid.uuid4()),
                                   "seed": random.randint(0, 1_000_000)},
                                    "recursion_limit": MAX_TURNS}
        await agent.ainvoke(
            {"messages": [SystemMessage(content=system_prompt),
            HumanMessage(content=scn.question)]},
            config=config,
        )

        if _nonlocal_final["value"]:
            traj.final_answer = _nonlocal_final["value"]
            reward, val, reason = judge_countdown_expression(
                scn.target, scn.nums, traj.final_answer.answer,
                enforce_integer_intermediates=True
            )
            traj.reward = float(reward)
            traj.metrics["correct"] = float(reward)
            traj.metrics["value"] = float(val) if isinstance(val,
                                    (int, float)) else float("nan")
            traj.metadata["last_reason"] = str(reason) if reason else ""

            traj.metadata["rubric"] = (
                "Score higher if the expression (1) hits the target, "
                "(2) uses each provided number at most once, "
                "(3) uses fewer operations, "
                "(4) avoids redundant parentheses and trivial +/-0 or *1 tricks, "
                "(5) avoids division when +, -, * suffice."
            )
    except Exception as e:
        # иҷрои ноком мукофоти 0 мегирад, аммо сабабаш дар траектория мемонад
        traj.metadata["error"] = f"{type(e).__name__}: {e}"
    return traj
Шарҳи қисмҳои код:
- Ба траектория майдони дорои навъи муайян барои натиҷаи абзори ниҳоии агент илова кунед.
- Объектҳои муштараки майдони корӣ вуҷуд доранд, ки абзорҳо онҳоро мехонанд ва тағйир медиҳанд.
- Агенти услуби ReAct бо се абзори шумо пайваст шудааст.
- Барои ҳар rollout риштаи иҷро ва seed-и алоҳида истифода мешавад: барои такрорпазирӣ ва ҷудо будани иҷроҳо.
- Барои пешгирӣ аз ҳалқаҳои беохири абзор маҳдудият гузошта шудааст.
- Ҷавоби баргардондаи абзор дар траектория нигоҳ дошта мешавад.
- Довари муайян мукофоти қатъӣ медиҳад.
- LLM-довари RULER меъёрномаро истифода мебарад.
Намунаи 13.10 нишон медиҳад, ки RULER-ро дар дохили ҳар гурӯҳ чӣ гуна истифода кардан мумкин аст.
Намунаи 13.10. Баҳодиҳии ҳар гурӯҳ бо RULER
ruler_model_id = "openai/gpt-4.1"
ruler_groups = []
for group in judged:
    try:
        rg = await ruler_score_group(group, ruler_model_id, debug=True)
    except Exception:
        rg = None
    ruler_groups.append(rg if rg is not None else group)
Шарҳи қисмҳои код:
- Аз довар талаб кунед, ки дар дохили ҳар гурӯҳ хол диҳад ва дараҷабандӣ кунад.
- Агар арзёбии довар ноком шавад, ба гурӯҳи бе арзёбӣ баргардед.
Намунаи 13.11 ҳар ду сигналро якҷоя мекунад, то омӯзиш аз танҳо дурустӣ фаротар равад. Танҳо ҳалли дуруст мукофот мегирад; баъдан RULER онҳоро дараҷабандӣ мекунад, то мукофот дақиқтар гардад.
Намунаи 13.11. Якҷоя кардани дурустӣ ва RULER тавассути мукофоти омехта
alpha, beta = 0.7, 0.3

def _combine(groups, alpha: float = 1.0, beta: float = 1.0):
    for g in groups:
        raw = []
        for t in g.trajectories:
            try:
                raw.append(float(t.reward))
            except Exception:
                raw.append(0.0)

        rmin = min(raw) if raw else 0.0
        rmax = max(raw) if raw else 0.0
        span = (rmax - rmin) if (rmax > rmin) else 1.0

        for t in g.trajectories:
            if t.metrics is None:
                t.metrics = {}
            if t.metadata is None:
                t.metadata = {}

            gate = float(t.metrics.get("correct", 0.0) or 0.0)
            gate = 1.0 if gate >= 0.5 else 0.0

            try:
                ruler_raw = float(t.reward)
            except Exception:
                ruler_raw = 0.0
            ruler_norm = (ruler_raw - rmin) / span
            ruler_norm = max(0.0, min(1.0,
                         ruler_norm)) if ruler_norm == ruler_norm else 0.0

            final_reward = gate * (alpha + beta * ruler_norm)
            final_reward = max(0.0, min(1.0, final_reward))

            t.metadata["ruler_score_raw"] = float(ruler_raw)
            t.metrics["ruler_norm"] = float(ruler_norm)
            t.metrics["final_reward"] = float(final_reward)
            t.reward = float(final_reward)
    return groups

hybrid_groups = _combine(ruler_groups, alpha=alpha, beta=beta)
Шарҳи қисмҳои код:
- Вазни дурустӣ дар муқоиса бо сифат: онро барои вазифаи худ танзим кунед.
- Мукофотҳои доварро ҳамчун сигнали сифат истифода баред.
- Нормализатсияи устувор дар дохили гурӯҳ аз тақсим ба сифр пешгирӣ мекунад.
- Дарвозаи дуҳолата аз довари муайян кафолат медиҳад, ки дақиқӣ дар ҷои аввал аст.
- Қиматҳоро ба ҳудуди иҷозатдодашуда маҳдуд кунед ва аз NaN муҳофизат намоед.
- Формулаи шаклдиҳии мукофот сода ва фаҳмопазир аст.
- Холҳои хом ва нормализатсияшударо нигоҳ доред.
- Мукофоти траекторияро бо мукофоти омехтае иваз кунед, ки барои омӯзиш истифода мешавад.
Намунаи 13.12 ҳалқаи омӯзишро танзим ва иҷро мекунад. ART сенарияҳоро пайдарпай коркард мекунад, гурӯҳҳои траекторияҳоро ҷамъ менамояд, мукофоти омехтаро татбиқ мекунад ва сиёсатро нав мекунад.
Намунаи 13.12. Иҷрои ҳалқаи омӯзиш
training_config = {
    "groups_per_step": 4,
    "num_epochs": 1,
    "rollouts_per_group": 2,
    "learning_rate": 1e-5,
    "max_steps": 3,
}

train_slice = train_scenarios[:64]

training_iterator = iterate_dataset(
    train_slice,
    groups_per_step=training_config["groups_per_step"],
    num_epochs=training_config["num_epochs"],
    initial_step=await model.get_step(),
)

for batch in training_iterator:
    print(f"Training step {batch.step}, epoch {batch.epoch}")
    groups = []
    for scn in batch.items:
        group = art.TrajectoryGroup(
            [wrap_rollout(model, rollout)(model,
            CountdownScenario(step=batch.step, scenario=scn))
              for _ in range(training_config["rollouts_per_group"]) ]
        )
        groups.append(group)

    finished = await art.gather_trajectory_groups(
        groups, pbar_desc="gather",
        max_exceptions=training_config["rollouts_per_group"] * len(batch.items),
    )

    # ҳар гурӯҳро RULER хол медиҳад, баъд мукофоти омехта (намунаи 13.11)
    ruler_groups = [await ruler_score_group(g, "openai/o3") for g in finished]
    hybrid_groups = _combine(ruler_groups, alpha=alpha, beta=beta)

    await model.train(
        hybrid_groups,
        config=art.TrainConfig(learning_rate=training_config["learning_rate"]),
        _config={"logprob_calculation_chunk_size": 8},
    )
Шарҳи қисмҳои код:
- Шумораи сенарияҳоро барои ҳар қадами беҳинасоз муайян кунед.
- Шумораи rollout-ҳоро барои ҳар сенария муайян кунед: онҳо маҷмӯи муқоисаро ташкил медиҳанд.
- Ҳангоми ислоҳи хатоҳо шумораро хурд нигоҳ доред, то омӯзиш аз назорат берун наравад.
- Барои гузариши аввалини зуд қисми хурди додаҳоро истифода баред.
- Барои аз нав идома додани бехатар қадами умумии ҷориро бихонед.
- Ҷамъоварии асинхронӣ ба rollout-ҳои суст имкон медиҳад бе бастани ҳалқа анҷом ёбанд.
- Гурӯҳҳои ҷамъшударо бо RULER хол диҳед ва мукофоти омехтаро татбиқ кунед.
- Навсозии GRPO-ро бо мукофотҳои омехта дар ҳар қадами ҳалқа иҷро кунед.
Барои санҷидани агенти омӯзонидашуда метавонед намунаи 13.13-ро дар чанд намунаи барои санҷиш ҷудошуда иҷро кунед.
Намунаи 13.13. Санҷидани агенти омӯзонидашуда
for scn in test_scenarios[:10]:
    res = await wrap_rollout(model, rollout)(model,
                CountdownScenario(step=0, scenario=scn))
    expr = res.final_answer.answer if res.final_answer else None
    reward, val, reason = judge_countdown_expression(scn.target, scn.nums,
                          expr or "", enforce_integer_intermediates=True)
    status = "CORRECT" if reward == 1.0 else f"WRONG ({reason})"
    print(f"nums={scn.nums} target={scn.target} -> {expr} => {status}")
Шарҳи қисмҳои код:
- Барои арзёбӣ ҳамон сиёсати омӯзонидашуда ва ҳамон ҳалқаи абзорҳоро истифода баред.
- Агар ҷавоби абзори ниҳоӣ мавҷуд бошад, онро гиред.
- Истифодаи ҳамон довари қатъии давраи омӯзиш муқоисаи яксонро таъмин мекунад.
Натиҷаи чоп чунин аст:
nums=[22, 89, 16] target=51 -> None => WRONG (empty expression)
nums=[85, 45, 75, 10] target=25 -> ((75-10)-(85-45)) => CORRECT
nums=[68, 96, 50, 3] target=75 -> ((50-3)-(68-96)) => CORRECT
nums=[49, 94, 73, 40] target=12 -> ((40-73)-(49-94)) => CORRECT
nums=[40, 79, 73] target=34 -> (73+(40-79)) => CORRECT
nums=[21, 1, 33, 2] target=40 -> (33+(21/(1+2))) => CORRECT
nums=[29, 1, 4, 46] target=66 -> ((4*(29-1))-46) => CORRECT
nums=[19, 97, 98] target=18 -> ((19+97)-98) => CORRECT
nums=[55, 76, 1] target=22 -> (1-(55-76)) => CORRECT
nums=[31, 4, 16, 36] target=20 -> None => WRONG (empty expression)
CORRECT маънои «дуруст»-ро дорад; WRONG (empty expression) — «нодуруст: ифода холӣ аст».
Ин равшан нишон медиҳад, ки агент ҳалли вазифаҳои Countdown-ро бомуваффақият омӯхтааст, гарчанде мо танҳо қисми хурди маҷмӯи додаҳоро истифода бурдем.
Ҳисоббарорӣ ҳангоми санҷиш: тавозуни андозаи модел ва андеша
Танҳо бо калон кардани модел то ҳадди муайян пеш рафтан мумкин аст. Омӯзондани моделҳои забонии ҳарчи калонтар захираҳои азим талаб мекунад ва зуд ба равиши ғайриустувор табдил меёбад. Аммо қобилияти андешаронӣ танҳо аз андоза намеояд. Таҳқиқоти нав нишон медиҳанд, ки ҳатто моделҳои хурдтар, агар ҳангоми санҷиш барои фикр кардан вақти бештар гиранд, метавонанд натиҷаҳои хеле хуб диҳанд.
Ба ҷойи зиёд кардани параметрҳо, метавонед ҳисоббарориро ҳангоми инференс, яъне истифодаи модел барои ҳосил кардани ҷавоб, зиёд кунед. Ба модел иҷозат медиҳед бештар мулоҳиза кунад, чанд идеяро ҷустуҷӯ намояд ва пеш аз интихоби ҷавоби ниҳоӣ ҷавобҳояшро такмил диҳад. Ин равиш фаҳмиши миқёсро дигар мекунад: миқёс дигар на нейронҳои бештар, балки андешаронии мақсадноки бештар аст. То ин ҷо ба агент омӯхтанро ёд додед; акнун ба ӯ фикр карданро меомӯзонед. Дар ҳамин ҷо системаҳои омӯзандаи шумо ба системаҳои андешанда табдил меёбанд.
Ин метавонад намунагирии чанд роҳи андешаронӣ, таҳлили қадамҳои мобайнӣ ё ислоҳи ҷавобҳо аз рӯйи бозхӯрд бошад. Натиҷа агентест, ки сарф кардани захираи ҳисоббарориро дар ҷойҳои муҳим меомӯзад. Ӯ метавонад натиҷаҳои алтернативиро симулятсия кунад, онҳоро арзёбӣ намояд ва андешаронии худро ба таври динамикӣ такмил диҳад. Идеяи зиёд кардани вақти фикр ба ҷойи андозаи модел яке аз роҳҳои умедбахштарин ба сӯйи агентҳои тавонотару самараноктар аст.
Барои дастгирии ин гузариш моделҳои афзалият ва мукофот нақши нав мегиранд. Онҳо дигар танҳо ҳангоми омӯзиш истифода намешаванд, балки қисми худи раванди инференс мегарданд. Ба ҷойи баҳодиҳии як ҷавоби ниҳоӣ, онҳо андешарониро дар ҷараёни ташаккули он роҳнамоӣ мекунанд. Ҳар қадам ё шохаи андешарониро метавон арзёбӣ ва муқоиса кард, монанди он ки инсон як далелро баррасӣ мекунад ё хатои кодро меёбад. Ин ҳалқаи бозхӯрд ба моделҳои хурдтар имкон медиҳад дар вазифаҳои мураккаби андешаронӣ ба моделҳои калонтар баробар шаванд ё ҳатто аз онҳо пеш гузаранд. Ин махсусан ҳангоми маҳдуд будани захираҳо ё зарурати кори самаранок дар дастгоҳҳои маҳаллӣ муҳим аст.
Барои зиёд кардани ҳисоббарории вақти санҷиш метавонед алгоритмҳои ҷустуҷӯи дарахтиро истифода баред. Онҳо ба агентҳо ёрӣ медиҳанд, ки кӯшиши андешарониро ба таври мутобиқшаванда тақсим кунанд. Яке аз тавонотарин усулҳо ҷустуҷӯи дарахтии Монте-Карло (Monte Carlo Tree Search — MCTS) мебошад. MCTS ба LLM имкон медиҳад фазои сохторёфтаи ҷавобҳои эҳтимолиро ҷустуҷӯ карда, тадриҷан ба беҳтарин ҷавоб расад. Он кунҷковӣ ва тамаркузро дар тавозун нигоҳ медорад: барои пайдо кардани идеяҳои нав ба қадри кофӣ васеъ ва барои такмил додани онҳо ба қадри кофӣ амиқ ҷустуҷӯ мекунад.
Аз намунагирӣ ба ҷустуҷӯ: тавозуни кашфи нав ва истифодаи маълумоти мавҷуда
Пеш аз баррасии муфассали алгоритмҳои мутобиқшаванда, аз ду стратегияи содатар оғоз кардан муфид аст. Ду усул заминаи хубе барои фаҳмидани интихоби байни ҷустуҷӯи ҷавобҳои бештар ва амиқтар кардани як ҷавоби мушаххас медиҳанд: мутаносибан намунагирии такрорӣ ва намунагирии пайдарпай. Дар намунагирии такрорӣ, ки дар расми 13.6 нишон дода шудааст, модел барои як промпт чанд ҷавоби мустақил мегирад. Ин равиш танҳо паҳноиро ҷустуҷӯ мекунад: гуногунӣ медиҳад, аммо такмил намедиҳад. Баръакс, такмили пайдарпай ба умқ тамаркуз мекунад: аз як ҷавоби ибтидоӣ оғоз карда, онро чанд бор беҳтар менамояд. Ҳар ду усул муфиданд, аммо ҳар яке танҳо нисфи ниёзҳои андешаронии воқеиро фаро мегирад.
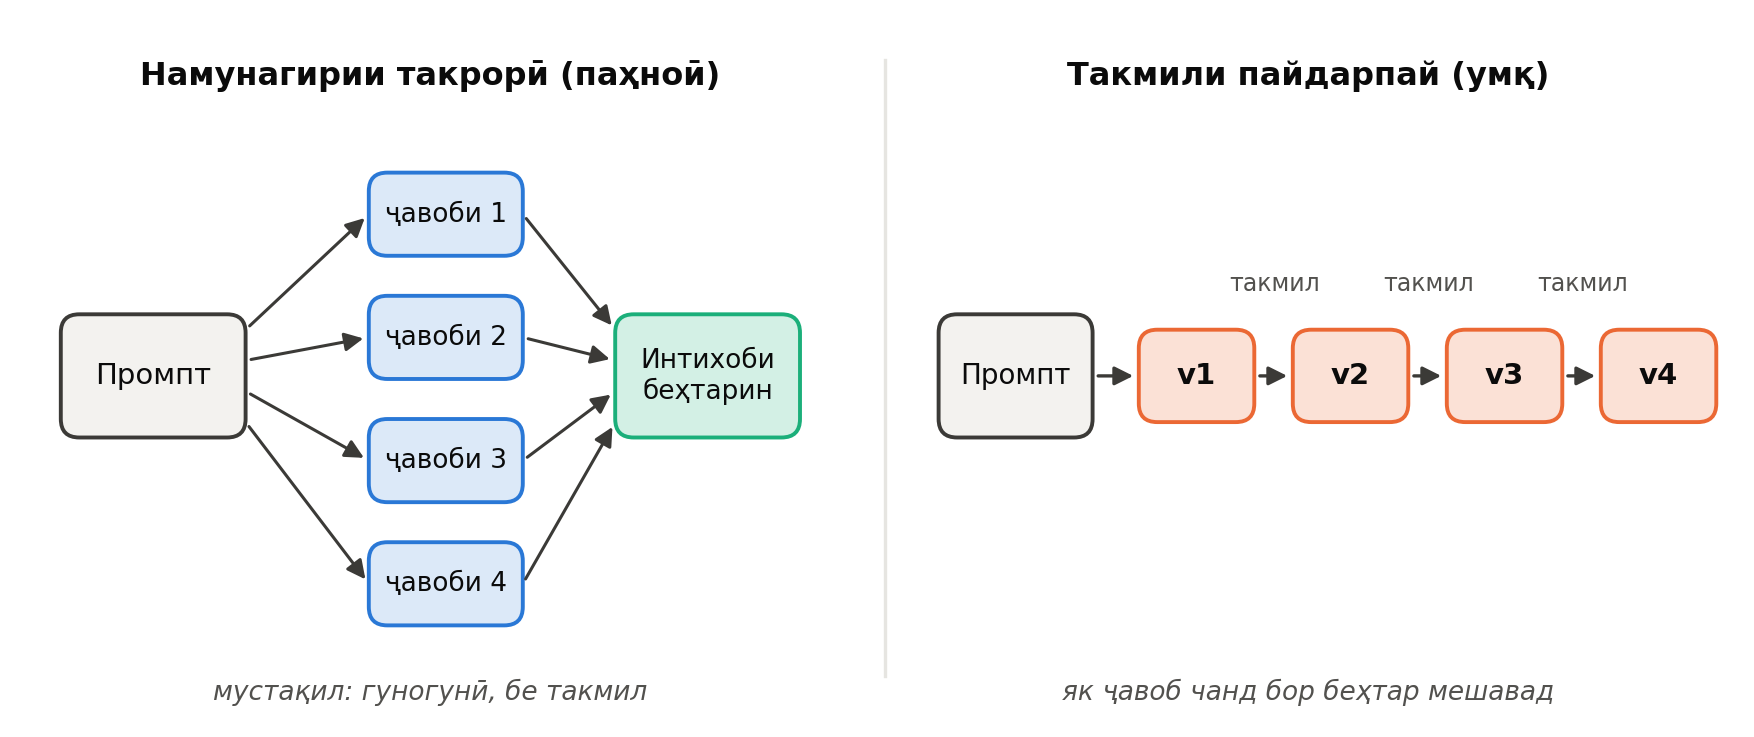
Расми 13.6. Стратегияҳои ҳамвори намунагирӣ: намунагирии такрорӣ дар муқоиса бо такмили пайдарпай.
MCTS ин мафҳумро тавассути сохтани дарахти ҷустуҷӯ дар чор қадами такроршаванда васеъ мекунад. Аввал интихоб анҷом мешавад: алгоритм аз реша дарахтро тай намуда, шохаҳоеро интихоб мекунад, ки мувофиқи қоидаи баҳодиҳӣ, масалан ҳадди болоии эътимод барои дарахтҳо (Upper Confidence Bound for Trees — UCT), кашфи нав ва истифодаи маълумоти мавҷударо дар тавозун нигоҳ медоранд. Ин тавозун дар RL ҳамчун мувозинати exploration–exploitation шинохта мешавад: аз як тараф, ҷамъ кардани иттилои нав барои кашфи роҳҳои эҳтимолан беҳтар; аз тарафи дигар, истифодаи иттилои аллакай ҷамъшуда барои беҳтарин натиҷа. Дар UCT гиреҳи навбатӣ барои васеъкунӣ тавассути якҷоя кардани арзиши тахминии он бо бонуси ҷустуҷӯ интихоб мешавад. Ин бонус бо зиёд шудани шумораи боздидҳои гиреҳи волидайн меафзояд ва бо зиёд шудани боздидҳои гиреҳи фарзанд кам мешавад. Қоидаи маъмули баҳодиҳии UCT барои ҳолати фарзанд чунин аст:
[ \mathrm{UCT}(j) = \frac{V_j}{n_j} + c \sqrt{\frac{\ln N}{n_j}} ]
Дар ин ҷо (V_j) — ҷамъи мукофотҳои гиреҳи фарзанди (j), (n_j) — шумораи боздидҳои он, (N) — шумораи боздидҳои гиреҳи волидайн ва (c) — вазни танзимшавандаи ҷустуҷӯ. Ҷузъи аввал истифодаи маълумоти мавҷударо ифода мекунад, ҷузъи дуюм — кашфи навро. Намунаи 13.14 амалисозии онро дар Python нишон медиҳад.
Намунаи 13.14. Амалисозии UCT
def upper_confidence_bound(self, exploration_weight=1.0):
    if self.parent is None:
        raise ValueError("Cannot obtain UCT from root node")
    if self.visits == 0:
        return float("inf")
    parent_visits = max(1, self.parent.visits)
    average_reward = self.value / self.visits
    exploration_term = math.sqrt(math.log(parent_visits) / self.visits)
    return average_reward + exploration_weight * exploration_term
Пас аз пайдо кардани шохаи умедбахш, раванд ба васеъкунӣ мегузарад: гиреҳҳои нави фарзанд сохта мешаванд, ки роҳҳои нави ҳалли номзадро ифода мекунанд. Аз он ҷо модел симулятсия ё rollout анҷом медиҳад: аз он гиреҳ як ҳалли пурра тавлид ва арзёбӣ мекунад. Ниҳоят, паҳнкунии натиҷа ба ақиб (backpropagation) тамоми гиреҳҳои волидайнро бо натиҷа нав мекунад. Ин ба система имкон медиҳад фаҳмиши худро аз самтҳои умедбахш такмил диҳад. Расми 13.7 ҳалқаи банақшагирӣ, арзёбӣ ва таҳлилро нишон медиҳад.
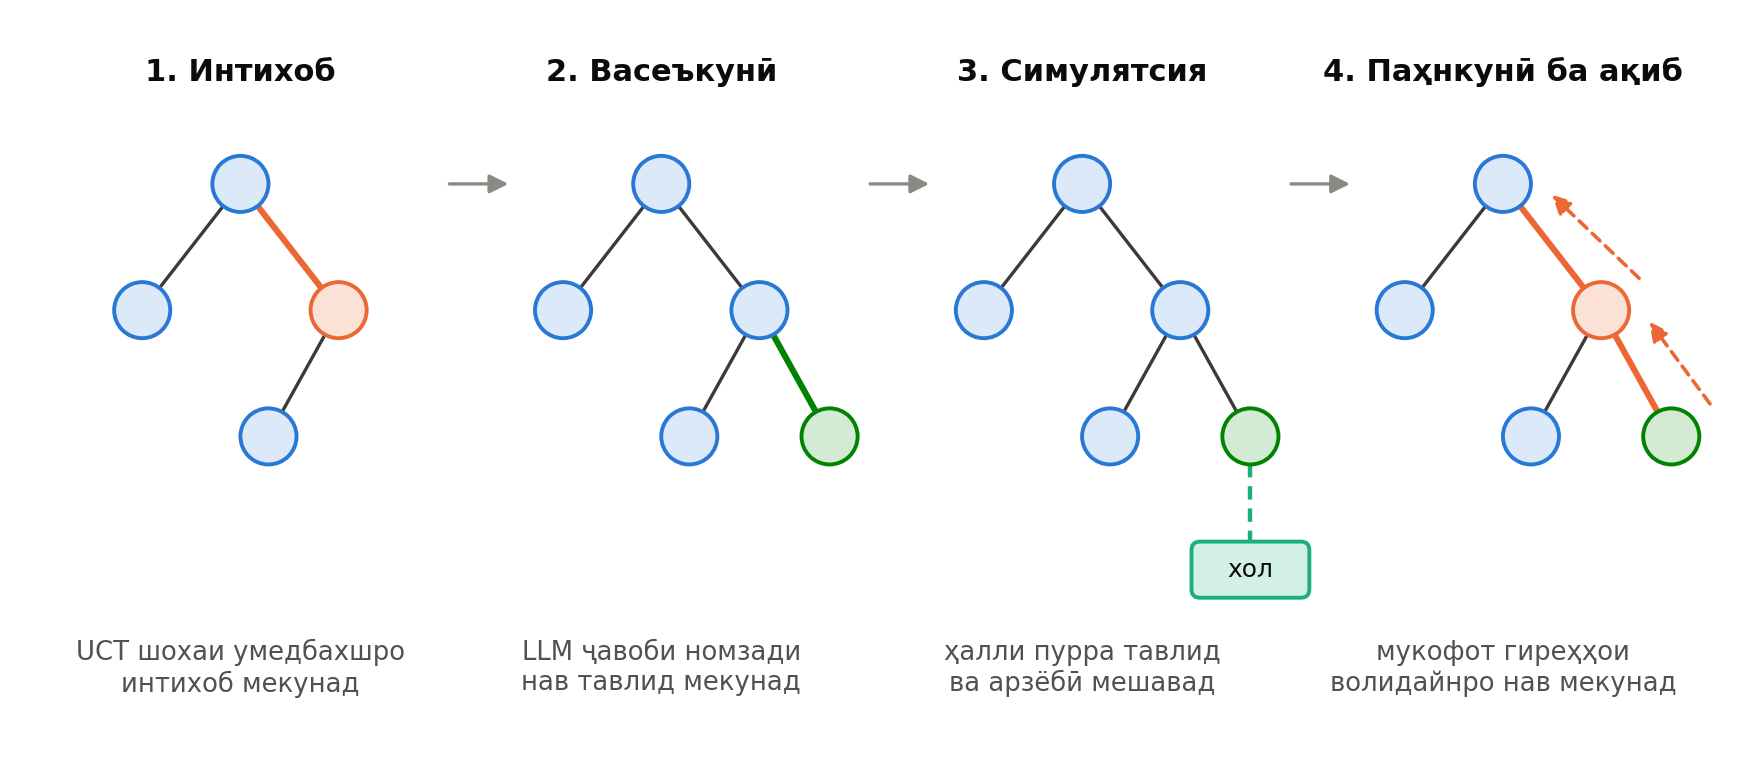
Расми 13.7. Татбиқи ҷустуҷӯи дарахтии Монте-Карло ба андешаронии LLM.
Ҳангоми санҷиш буҷети андешаронии модел ба иҷрои ҳамин ҳалқа сарф мешавад: интихоб, васеъкунӣ, симулятсия ва паҳнкунии натиҷа ба ақиб. LLM ҷавобҳои номзад тавлид мекунад, онҳоро арзёбӣ менамояд ва аз ин арзёбиҳо барои роҳнамоии қадами навбатӣ истифода мебарад. Ин раванд ба модел имкон медиҳад нисбат ба декодкунии содаи якгузар имкониятҳои бештарро ҷустуҷӯ кунад ва роҳҳои ҳалли ҳам босифаттар ва ҳам фаҳмонданашон осонтарро ҳосил намояд.
Ҷустуҷӯи дарахтии Монте-Карло бо шохабандии мутобиқшаванда (AB-MCTS)
Adaptive Branching Monte Carlo Tree Search — AB-MCTS⁴ усули стандартии MCTS-ро васеъ мекунад: ба таври динамикӣ қарор медиҳад, ки шохаҳои навро ҷустуҷӯ кунад ё шохаҳои мавҷударо такмил диҳад. Ин қароргирии мутобиқшаванда ҳамон тавозуни классикии кашфи нав ва истифодаи донишҳои мавҷуда дар RL мебошад.
Ин чандирӣ барои агентҳо зарур аст, зеро ҳатто як промпт метавонад навъҳои бешумори ҷавобҳоро тавлид кунад. Шумораи собити шохаҳо, ки дар MCTS-и стандартӣ истифода мешавад, ин имкониятро маҳдуд мекунад. AB-MCTS ин маҳдудиятро бо иҷозат додани рушди дарахт мувофиқи эҳтиёҷ бартараф менамояд. Расми 13.8 фарқи онро аз MCTS-и анъанавӣ нишон медиҳад.
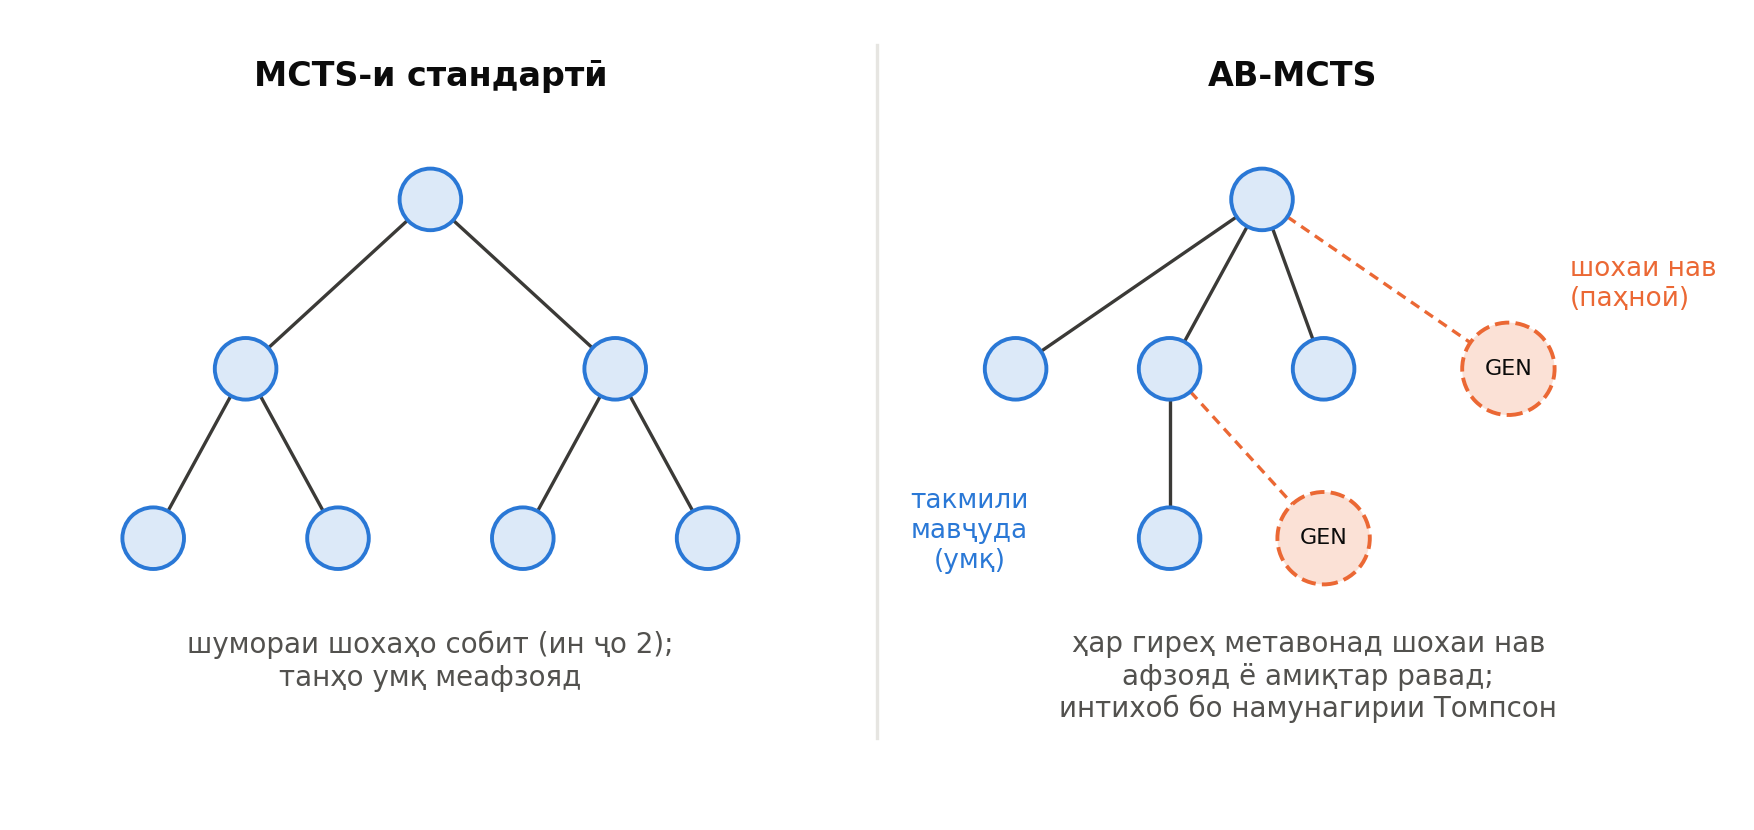
Расми 13.8. Муқоисаи MCTS ва AB-MCTS.
AB-MCTS зери ҳар гиреҳи дарахт як гиреҳи GEN илова мекунад. Вақте он интихоб мешавад, ба модел сигнал медиҳад, ки ҷавоби номзади нав тавлид кунад; яъне шохаи нав сохта мешавад. Интихоби тавлиди роҳи нав ё такмили роҳи мавҷуда бо намунагирии Томпсон (Thompson sampling) роҳнамоӣ мегардад: стратегияи байесӣ, ки кашфи нав ва истифодаи маълумоти мавҷударо вобаста ба номуайянӣ дар тавозун нигоҳ медорад.
Ду варианти асосӣ вуҷуд дорад. AB-MCTS-M (модели омехта) барои арзёбии холҳои GEN ва гиреҳҳои мавҷуда модели байесии махсуси ҳар гиреҳро истифода мебарад. Аз холҳои мушоҳидашудаи зердарахтҳо тақсимотҳои пешгӯии пасин месозад, ки қарорҳои ҷустуҷӯро роҳнамоӣ мекунанд. Ин ба модел имкон медиҳад мукофотҳои эҳтимолиро ҳатто барои роҳҳои ҳанӯз ҷустуҷӯнашуда тахмин кунад ва бо додаҳои маҳдуд қарорҳои асоснок гирад. Расми 13.9 ин механизмро нишон медиҳад.
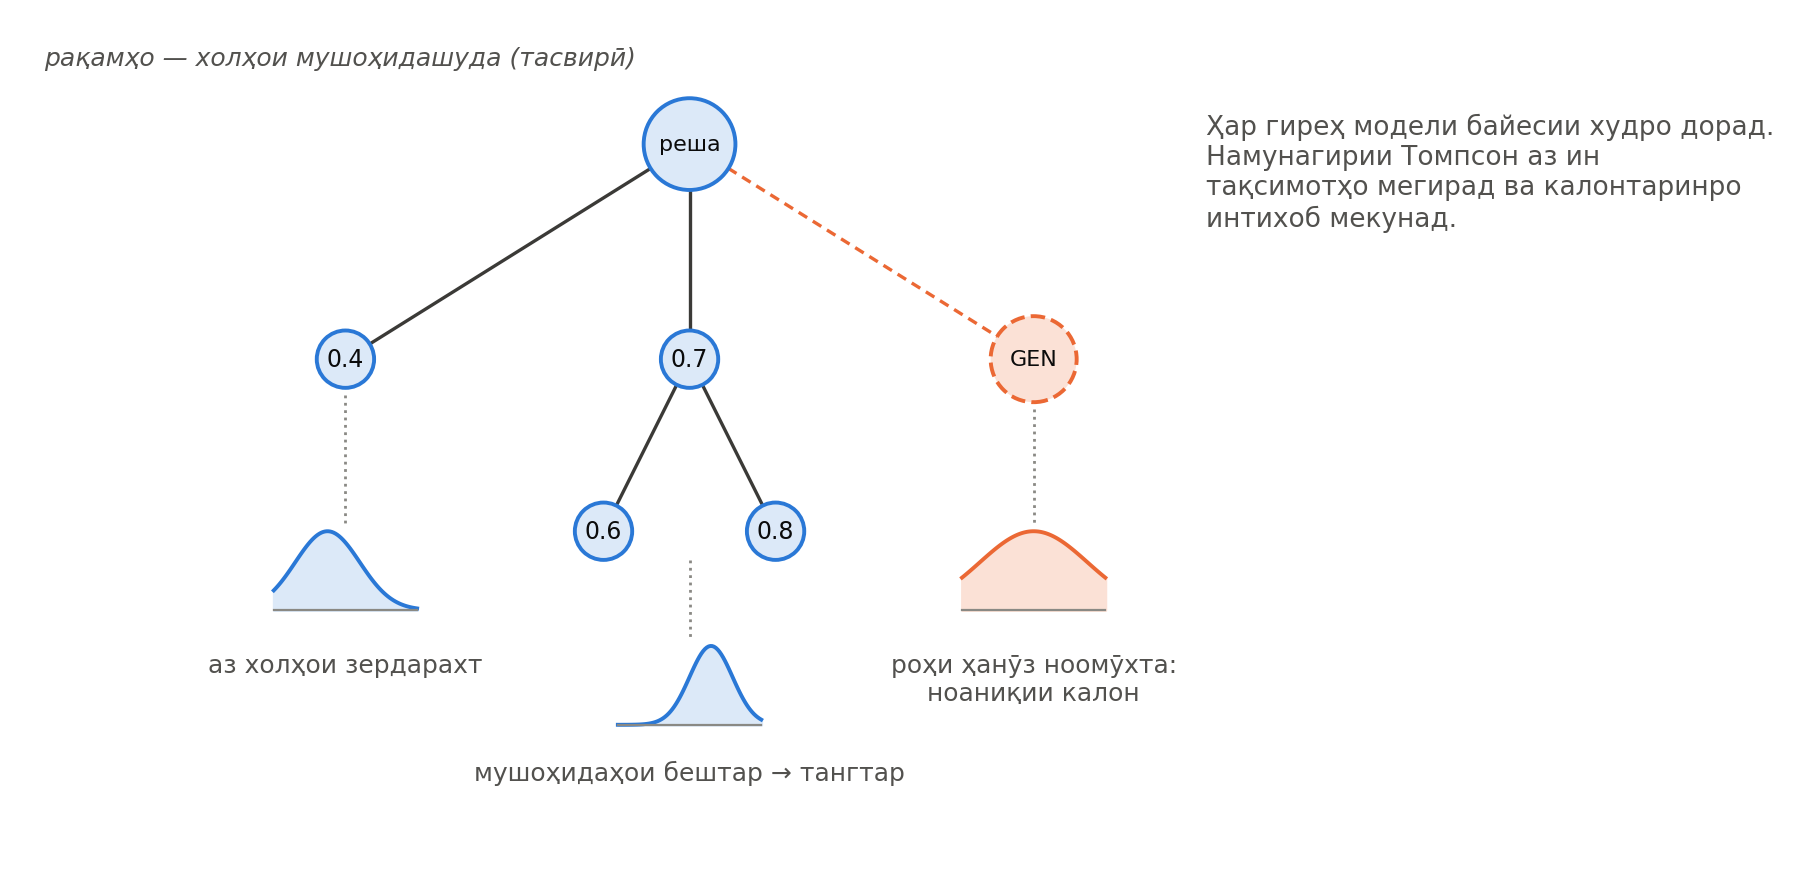
Расми 13.9. Сохтори дарахт ва тақсимотҳои пешгӯии пасин барои AB-MCTS-M. Тасвир аз кори Юичи Иноуэ ва ҳамкорон (2025) мутобиқ карда шудааст.
Варианти дуюм, AB-MCTS-A (ҷамъбандии гиреҳҳо), содатар ва ба MCTS-и стандартӣ наздиктар аст. Он зери ҳар гиреҳи ҷавоб гиреҳи CONT илова мекунад, ки такмилро ифода менамояд. Ҳар гиреҳ метавонад ё номзадҳои нав тавлид кунад — тавассути GEN — ё беҳтар кардани ҷавоби мавҷударо идома диҳад — тавассути CONT. Ин тарҳ хароҷоти ҳисоббарориро маҳдуд карда, чандирии ҷустуҷӯро нигоҳ медорад. Вобаста ба тақсимоти мукофотҳо, AB-MCTS-A метавонад тақсимотҳои пешини гауссӣ ё бета-ро барои нормализатсияи холҳо дар фосилаи аз 0 то 1 истифода барад. Расми 13.10 тарзи инкишофи чунин дарахтро нишон медиҳад.
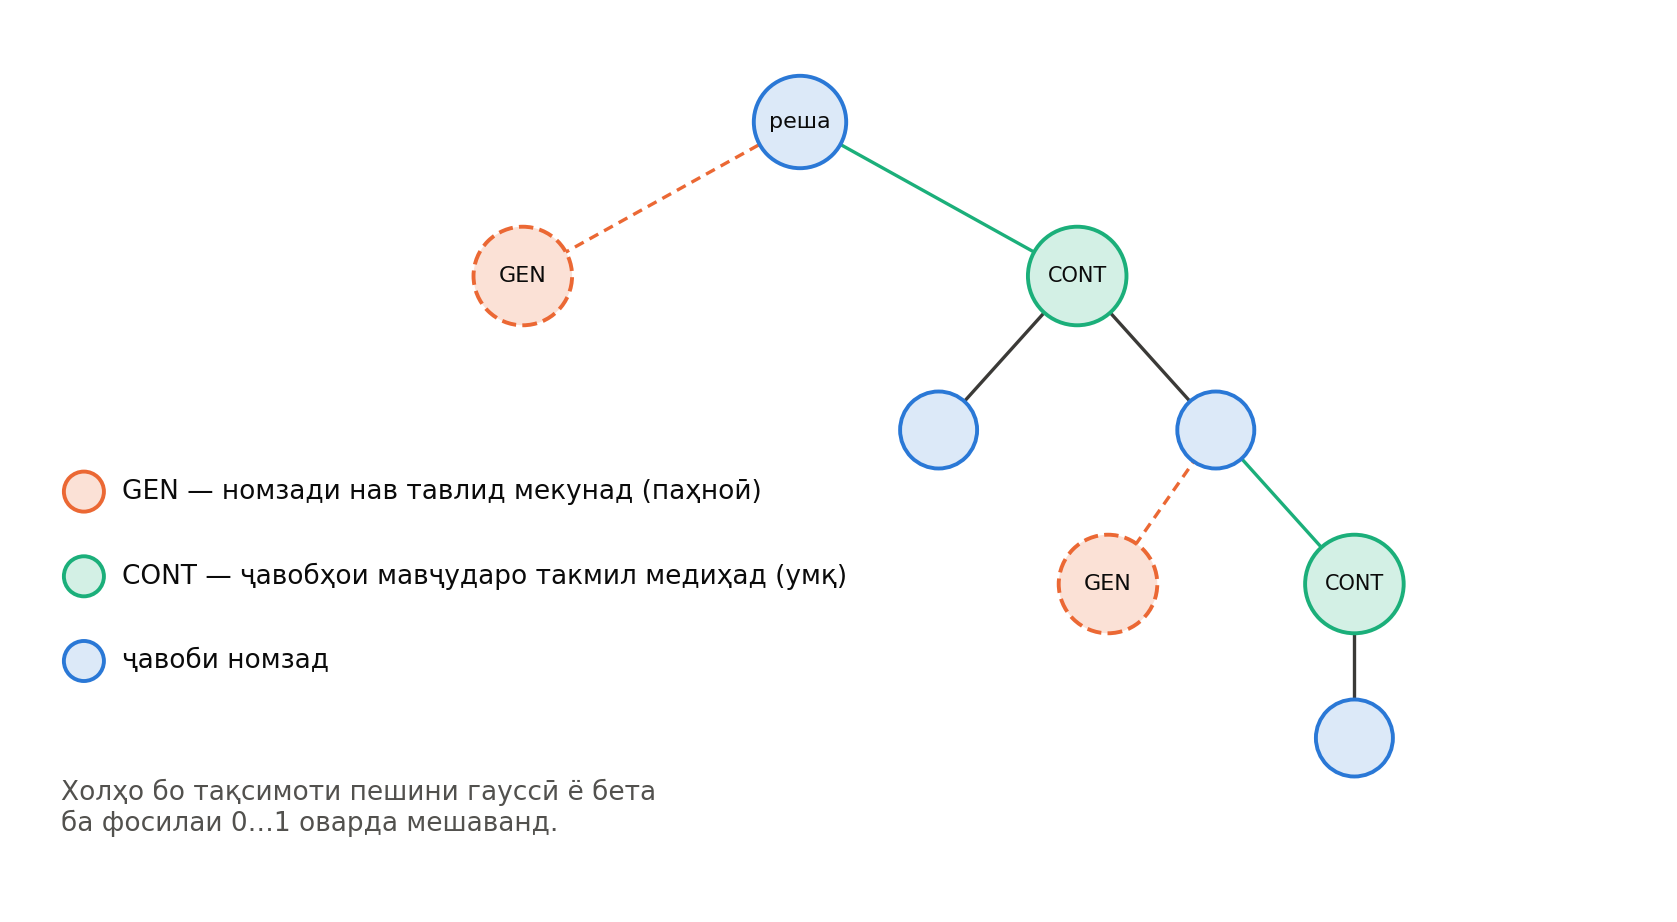
Расми 13.10. Сохтори дарахти AB-MCTS-A бо гиреҳҳои CONT ва GEN. Тасвир аз кори Юичи Иноуэ ва ҳамкорон (2025) мутобиқ карда шудааст.
Ҳар ду варианти AB-MCTS барои роҳнамоии ҷустуҷӯ ба навсозии байесӣ такя мекунанд. LLM ҷавобҳоро пай дар пай тавлид, арзёбӣ ва такмил медиҳад ва кӯшиши ҳисоббарории худро дар ҷойҳое тақсим мекунад, ки фоидаи бештар доранд. Ин ба модел имкон медиҳад мутобиқшаванда мулоҳиза кунад: ҳангоми номуайянӣ ҷустуҷӯ намояд ва ҳангоми эътимод аз натиҷаҳои мавҷуда истифода барад.
Барои нишон додани ин, мисоли навбатӣ китобхонаи кушодаасоси TreeQuest-ро барои такмил додани коди Python-и пайдарпайии Фибоначчи истифода мебарад. Он нишон медиҳад, ки ҷустуҷӯи дарахтӣ чӣ гуна паҳноӣ ва умқро дар тавозун нигоҳ медорад, то ҷавоби агенти LLM-ро қадам ба қадам беҳтар кунад.
Намунаи 13.15 номзади аввалро месозад ва баҳогузорӣ мекунад. Он аз сифр ҳалли ибтидоӣ омода менамояд, доварро даъват мекунад ва объекти State бармегардонад, ки MCTS метавонад онро ҳамчун фарзанди реша истифода барад.
Намунаи 13.15. Тавлиди ҷавоби ибтидоӣ
def initial_generation() -> State:
    prompt = "Q: Write code in Python for the Fibonacci sequence. \nA:"
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.7,
    )
    answer = response.choices[0].message.content.strip()
    score = evaluate_answer(answer)
    return State(llm_answer=answer, score=score)
Шарҳи қисмҳои код:
- Моделеро истифода баред, ки барои арзёбии баъдӣ формати ҷавоби JSON-ро дастгирӣ кунад.
- Ҳарорати муътадил гуногуниро барои шохаҳои оянда дастгирӣ мекунад.
- Ҷавоб хударзёбӣ мешавад, то фарзандони реша аз оғоз хол дошта бошанд.
Баъдан намунаи 13.16 ҷавоби мавҷударо мақсаднок беҳтар карда, аз нав баҳогузорӣ мекунад.
Намунаи 13.16. Такмил додани ҷавоб
def refine_answer(llm_answer: str, score: float) -> State:
    prompt = f"""The current answer is:\n\n{llm_answer}\n\nPlease improve this
            answer to be more informative, accurate, and clear."""
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.7,
    )
    refined = response.choices[0].message.content.strip()
    score = evaluate_answer(refined)
    return State(llm_answer=refined, score=score)
Шарҳи қисмҳои код:
- Боз ҳам моделеро истифода баред, ки ҷавоби услуби JSON-ро дастгирӣ кунад.
- Ҷавоби такмилшударо ҳамеша аз нав баҳогузорӣ кунед, то дарахти ҷустуҷӯ нав шавад.
Намунаи 13.17 аз LLM-довар талаб мекунад, ки объекти JSON бо як калиди score баргардонад. Он муштарии OpenAI-ро бо таҳлили сохторёфта ба ScoreResponse истифода мебарад. Агар хато рӯй диҳад, ба холи бетараф бармегардад, то ҷустуҷӯ идома ёбад.
Намунаи 13.17. LLM-довар бо таҳлили сохторёфта
def evaluate_answer(answer: str) -> float:
    prompt = (
        f"Evaluate the quality of this answer on a scale from 0 to 1.\n"
        f"Return a JSON object like {{\"score\": 0.92}}.\n\n"
        f"Answer:\n{answer}"
    )

    try:
        completion = client.chat.completions.parse(
            model="gpt-4o",
            messages=[{"role": "user", "content": prompt}],
            response_format=ScoreResponse,
        )
        return completion.choices[0].message.parsed.score
    except Exception as e:
        print(f"[Evaluation error] {e}")
        return 0.5
Шарҳи қисмҳои код:
- Табдили сохторёфта ба
ScoreResponseаз таҳлили осебпазири сатрҳо пешгирӣ мекунад. - Холи бетарафи эҳтиётӣ ҳангоми нокомии довар имкон медиҳад ҷустуҷӯ идома ёбад.
Агар parent_state набошад, намунаи 13.18 номзади ибтидоӣ месозад; дар акси ҳол ҷавоби волидайнро такмил медиҳад.
Намунаи 13.18. Нуқтаи вуруди тавлид барои TreeQuest
def generate(parent_state: State | None) -> tuple[State, float]:
    if parent_state is None:
        state = initial_generation()
    else:
        state = refine_answer(parent_state.llm_answer, parent_state.score)
    return state, state.score
Шарҳи қисмҳои код:
- Даъвати аввал фарзанди ибтидоии решаро месозад, ки AB-MCTS метавонад онро васеъ кунад.
- Такмил ба интихоби CONT дар AB-MCTS-A ё гиреҳи мавҷудаи интихобшуда дар AB-MCTS-M мувофиқ аст.
- Қимати дуюм холи ҳамон ҷавоби нав аст (на холи волидайн): TreeQuest онро барои интихоби шохаи навбатӣ истифода мебарад.
Намунаи 13.19 ҳалқаи AB-MCTS-ро амалӣ ва иҷро мекунад.
Намунаи 13.19. Ҳалқаи TreeQuest
algo = tq.ABMCTSA()
search_tree = algo.init_tree()

for i in range(5):
    search_tree = algo.step(search_tree, {'LLM-Refine': generate})
    if (i + 1) % 5 == 0:
        best, _ = tq.top_k(search_tree, algo, k=1)[0]
        print(f"[Step {i+1}] Best so far: {best.llm_answer} (score={best.score:.2f})")

best_state, _ = tq.top_k(search_tree, algo, k=1)[0]
print(f"\n Final Best Answer: {best_state.llm_answer} (score={best_state.score:.2f})")
Шарҳи қисмҳои код:
- Шумораи ками қадамҳоро иҷро кунед: дар ин ҷо панҷ қадам. Дар истифодаи воқеӣ онро тадриҷан зиёд кунед.
- Беҳтарин натиҷаи то ин лаҳзаро давра ба давра санҷед.
- Интихоби ниҳоиро анҷом диҳед.
Қисме аз натиҷаи чопшудаи мо чунин аст:
[Қадами 5] Беҳтарин натиҷа то ин лаҳза: Албатта! Биёед шарҳ ва кодро такмил диҳем, то иттилоотноктар, дақиқтар ва равшантар шаванд.
Коди беҳтаршуда
Ин версияи ислоҳшудаи код бо шарҳҳои иловагӣ барои равшанӣ аст:
def fibonacci(n):
    """
    Generate the first n terms of the Fibonacci sequence.

    Parameters:
    n (int): The number of terms to generate.

    Returns:
    list: A list containing the first n terms of the Fibonacci sequence.
    """
    # Initialize the sequence list and the first two Fibonacci numbers
    sequence = []
    a, b = 0, 1

    # Generate Fibonacci numbers up to n terms
    while len(sequence) < n:
        sequence.append(a)  # Append the current number to the sequence
        a, b = b, a + b # Update a + b to the next two numbers in the sequence
    return sequence
Тарҷумаи ҳуҷҷатгузорӣ ва шарҳҳои ин код: функсия n узви аввали пайдарпайии Фибоначчиро тавлид мекунад; параметри n адади бутун ва шумораи узвҳои тавлидшаванда аст; натиҷа рӯйхати ин узвҳо мебошад. Аввал рӯйхат ва ду адади аввал оғозсозӣ мешаванд. Сипас то расидан ба n узв адади ҷорӣ ба рӯйхат илова шуда, ҷуфти ададҳо нав мегардад.
Чунонки мебинед, мо панҷ қадами такмил интихоб кардем ва ҳамин дар натиҷа инъикос шудааст. Ҷустуҷӯи дарахтӣ нишон медиҳад, ки зиёд кардани андешаронӣ ба ҷойи андозаи модел чӣ маъно дорад. Бо иҷозат додан ба агентҳо барои ҷустуҷӯ, арзёбӣ ва такмил, иқтидори хомро ба андешаи сохторёфта ва роҳнамоишуда иваз мекунед. Бо алгоритмҳое чун AB-MCTS, андешаронӣ тавассути ҳисоббарории вақти санҷиш ба раванди фаъол табдил меёбад, на танҳо як гузариш.
Фароҳам кардани барномаҳои агентии умумӣ тавассути омӯзиши баъдӣ ва агентҳои ба ҷустуҷӯ асосёфта
Чунонки дидед, RL ба агентҳо қобилияти беҳтаршавӣ аз доираи промптҳои собитро медиҳад ва ҳалқаи андешаронӣ, амал ва бозхӯрдро мепайвандад. Чаҳорчӯбаҳое чун ART ва RULER ин равандро амалӣ мегардонанд: ба агентҳо имкон медиҳанд аз траекторияҳои сохторёфта ва бозхӯрди нисбӣ омӯзанд, на аз тамғаҳои собит ё мукофотҳои дастӣ. Аммо вақте агентҳо мураккабтар мешаванд ва чанд нақши андешаронӣ, ҷараёнҳои кории шохадор ё стратегияҳои ҷустуҷӯиро якҷоя мекунанд, омӯзондани ин системаҳо мушкили навбатӣ мешавад. Дар ҳамин ҷо rLLM ҳамчун абзори арзишманди маҷмӯи такмили агентҳо ба кор медарояд. Дар ин бахш омӯзиш ба оркестратсия табдил меёбад. Ба чанд агенти LLM меомӯзонед, ки корро тақсим кунанд, натиҷаҳоро арзёбӣ намоянд, шохабандии шартӣ ва иҷрои параллелиро анҷом диҳанд ва ҷустуҷӯи дарахтиро ҳамчун гурӯҳ ҳамоҳанг кунанд, то якҷоя беҳтар шаванд.
rLLM чаҳорчӯбаи кушодаасос барои омӯзиши баъдии агентҳои забонӣ тавассути RL мебошад. Он имкон медиҳад агентҳо ва муҳитҳои махсус тарҳрезӣ кунед, онҳоро бо алгоритмҳои RL, аз ҷумла GRPO, омӯзонед ва барои сарбории муҳити воқеии истифода ҷойгир намоед. Аз ҷиҳати мафҳумӣ, он бар ҳамон принсипҳои бо RULER ва ART омӯхтаатон сохта шудааст, аммо онҳоро ба сатҳи баландтари абстраксия мебарад. Ба ҷойи омӯзондани як сиёсат, rLLM имкон медиҳад тамоми ҷараёнҳои кории агентӣ ба таври муштарак омӯзанд.
Дар асоси худ rLLM муҳаррики ҷараёни кор ва омӯзонандаро пешниҳод мекунад, ки якҷоя раванди RL-ро умумӣ мегардонанд. Муҳаррики ҷараёни кор барномаҳои мураккаби андешаронӣ ё бисёрагентиро иҷро мекунад, масалан системаҳои ҳалкунанда–довар ва ҳалқаҳои банақшагир–иҷрокунанда. Он ҳамчунин имкон медиҳад агентҳои ба ҷустуҷӯи дарахтӣ асосёфтаро бо MCTS истифода бурда, аз ҳар ҷузъ траектория ҷамъ кунед. Ҷузъи омӯзонанда ин траекторияҳоро ҷамъбандӣ менамояд, бартариҳои нисбиро ҳисоб мекунад ва бо регуляризатсияи KL навсозиҳо мегузаронад, то система устувор монад. rLLM агентҳои алоҳидаро ба системаи омӯзишпазир ва ҳамкор табдил додан ёрӣ медиҳад. Ҷадвали 13.7 се чаҳорчӯбаро муқоиса мекунад, то нақшҳои фарқкунанда, вале пурракунандаи онҳо дар маҷмӯи RL-и системаҳои агентӣ равшан шаванд. Ин муқоиса қабатӣ аст, на рақобатӣ: RULER сигнали мукофотро таъриф мекунад; ART траекторияҳои мукофотгирифтаро барои беҳинасозии агентҳои абзоркор истифода мебарад; rLLM ҳамин идеяро ба ҷараёнҳои кории калонтари агентӣ васеъ мекунад.
Ҷадвали 13.7. Чаҳорчӯбаҳои омӯзонидани агентҳо бо RL
| Чаҳорчӯба | Самти асосӣ | Механизми омӯзиш | Доираи истифода |
|---|---|---|---|
| RULER | Арзёбии нисбӣ тавассути LLM ҳамчун довар | Андешаронии сифатиро ба бозхӯрди миқдории нормализатсияшуда табдил медиҳад | Моделсозии мукофот ва доварӣ |
| ART | Омӯзиш бо тақвият барои агентҳои истифодабарандаи абзор | Rollout-ҳои сохторёфта ва навсозии сиёсат дар асоси GRPO | Беҳинасозии рафтор ва эътимоднокӣ |
| rLLM | Омӯзиш бо тақвият барои ҷараёнҳои кории агентӣ | Омӯзиши ягона дар равандҳои андешаронӣ, доварӣ ва ҷустуҷӯ | Омӯзиш ва ҳамоҳангсозӣ дар сатҳи система |
rLLM механизмҳои аллакай дар GRPO дидаатонро муттаҳид ва васеъ мекунад. Он ҳамчунин бо усулҳое чун MCTS мувофиқ кор мекунад. Ҳар гиреҳи дарахти ҷустуҷӯ ба қадами андешаронӣ табдил меёбад, ки онро бо омӯзиш бо тақвият беҳина кардан мумкин аст. Марҳилаҳои интихоб, васеъкунӣ, симулятсия ва паҳнкунии натиҷа ба ақиб (расми 13.7) ҳама траекторияҳои дорои натиҷаҳои ченшаванда тавлид мекунанд. Дар rLLM онҳоро метавон гурӯҳбандӣ, дараҷабандӣ ва такмил кард, то агентҳо тадриҷан ҷустуҷӯи самараноктарро омӯзанд, ба ҷойи он ки ба қоидаҳои эвристикии собит такя кунанд.
rLLM ба шумо ёрӣ медиҳад аз тарҳҳои назариявии омӯзиш бо тақвият ба системаҳои амалии андешаронӣ гузаред. Ҳамон ҷараёни идоракунӣ, ки барои инференс истифода мебаред — банақшагир ва иҷрокунандаи ҳамкор, ҳалкунанда ва довари муқоисакунандаи натиҷаҳо ё дарахти ҷустуҷӯи роҳҳои гуногун — акнун метавонад ҳалқаи омӯзиши шумо низ бошад. Ин фосилаи байни тарҳрезӣ ва ба истифода доданро мепайвандад, зеро раванди омӯзиш табиатан ба тарзи мавҷудаи андешаронии агентҳо мутобиқ мешавад.
rLLM имкон медиҳад навъҳои зиёди системаҳои агентиро омӯзонед, аз ҷумла ҷараёнҳои кории мураккаб бо чанд нақши андешаронӣ, доварон, шохаҳои шартӣ ва ҷузъҳои ҷустуҷӯ. Ҷараёни корро бо меросгирӣ аз синфи асосии Workflow, амалисозии мантиқ дар методи run() ва баргардондани объекти Episode муайян мекунед. Ин объект траекторияҳо ва мукофотҳоро сабт менамояд. Сипас чаҳорчӯба иҷро, мантиқи кӯшиши дубора, ҷамъоварии траекторияҳо ва беҳинасозии PPO/GRPO-ро оркестратсия мекунад. Ҳамин тавр, метавонед ба сохтори андешаронии агент диққат диҳед, ба ҷойи он ки тамоми зерсохтори омӯзишро худатон созед.
Барои нишон додани ин идея, анбори китоби аслӣ notebook-е дорад, ки ҷараёни кории ҳалкунанда–довар-ро намоиш медиҳад: агенти ҳалкунанда ҷавоб пешниҳод мекунад, агенти довар бошад онҳоро арзёбӣ карда, беҳтаринашро интихоб менамояд. Мукофоти ҳар ҳалкунанда ба дурустии ҳалли ӯ вобаста аст; мукофоти довар инъикос мекунад, ки оё ҳалли дурустро интихоб кардааст. Бо ҷамъ кардани ҳамаи траекторияҳо дар як Episode, ҳалкунанда ва довар метавонанд муштаракан омӯзонида шаванд. Система ҳамчун як раванди ҳамоҳанги андешаронӣ инкишоф меёбад. Ин равандро барои беҳтар кардани ҳамоҳангии системаҳои бисёрагентӣ (MAS) низ истифода бурдан мумкин аст.
Дар notebook-и намунавӣ ин сохтор ба бозии 24 татбиқ мешавад: масъалаи классикии андешаронии математикӣ. Чор адад дода мешаванд — масалан, 3, 3, 4 ва 5 — ва аз агент талаб мешавад онҳоро бо амалҳои арифметикӣ (+, −, ×, ÷) якҷоя карда, маҳз ба 24 расад. Агентҳои ҳалкунанда ифодаҳои гуногунро меозмоянд ва довар онҳоро арзёбӣ мекунад. Бо мурури вақт RL ба ҳар ду ҷузъ дар такмили стратегияҳои андешаронӣ ёрӣ медиҳад. Ин нишон медиҳад, ки тарҳи ҷараёни кории rLLM чӣ гуна омӯзиши аз аввал то охирро дар андешаронӣ, доварӣ ва арзёбӣ имконпазир мекунад.
Ин тарзи омӯзиш қадами равшан ба пеш аст. Ба ҷойи он ки моделҳоро ҷудогона танзими дақиқ карда, баъдан якҷоя кунед, метавонед тамоми меъмории андешарониро ҳамчун як система омӯзонед. Бозхӯрд аз ҳар қисми он мегузарад ва доварӣ, андешаронӣ ва ҷустуҷӯро ба як системаи таҳаввулёбанда мепайвандад. RULER ва ART ба агентҳо дар арзёбӣ ва беҳтар кардани рафтори худ ёрӣ медиҳанд; rLLM бошад ба тамоми система қобилияти омӯзиш ва андешаронӣ ҳамчун зеҳни ягонаи мутобиқшавандаро медиҳад.
Хулоса
Дарси асосии ин боб он аст, ки қобилияти агент аз динамикаи омӯзиш ва стратегияи инференс меояд, на аз андозаи модел. Мукофотҳо амалҳоро бо оқибатҳо мепайванданд, траекторияҳо андешарониро нигоҳ медоранд ва rollout-ҳо таҷрибаро ба сохтор табдил медиҳанд. Бо KL ҳамчун ресмони бехатарӣ, GRPO ва GSPO муқоисаҳои нисбиро ба навсозиҳои устувори сиёсат табдил медиҳанд. Ҳамин тавр, агентҳо на танҳо ҷавобҳо, балки раванди кори худро беҳтар мекунанд.
Сипас омӯхтед, ки чӣ гуна агентҳоро самаранок омӯзонед. RULER бе нишондиҳандаҳои дастӣ арзёбии пайгиронаи асосёфта ба меъёрнома медиҳад. ART бошад траекторияҳои арзёбишударо ба навсозиҳое табдил медиҳад, ки истифодаи абзорро боэътимодтар мекунанд. Мукофотҳои омехта санҷишҳои қатъии барномавиро бо арзёбии сифатии андешаронӣ якҷоя менамоянд ва ҳалқаи омӯзише месозанд, ки фаҳмопазир, аз ҷиҳати истифодаи додаҳо самаранок ва ба тарзи воқеии кори агентҳо мувофиқ аст.
Андешаронӣ бо анҷоми омӯзиш хотима намеёбад. Ҳисоббарории вақти санҷиш вазъро дигар мекунад: бо ҷудо кардани вақти бештар барои фикр ҳангоми инференс, моделҳои хурдтар метавонанд тавассути ҷустуҷӯ ва такмили роҳҳои алтернативӣ беҳтар шаванд. MCTS ин андешаро ташкил мекунад; AB-MCTS бошад паҳноӣ ва умқро бо навсозиҳои байесӣ мутобиқ месозад. Ҳамин тавр, агентҳо ҳангоми номуайянӣ ҷустуҷӯ мекунанд ва ҳангоми эътимод такмил медиҳанд. Ҷустуҷӯ ба қисми асосии андешаронӣ табдил меёбад, на чизе, ки баъдан ба он илова шавад.
Чиро бояд дар ёд дошт
- Ҳар иҷрои агент як траектория аст. Траекторияҳоро сабт ва баҳогузорӣ карда, агентро беҳтар мекунем — аксар вақт бо тағйири промпт ва абзорҳо, на вазнҳои модел.
- Муқоисаи якчанд ҷавоб ба як вазифа аз додани баҳои мутлақ ба як ҷавоб осонтар ва боэътимодтар аст: GRPO ва RULER ба ҳамин ғоя такя мекунанд.
- Мукофоти омехта беҳтар кор мекунад: санҷиши дурустӣ бо код ва баҳои сифат аз LLM-довар.
- «Бештар фикр кардан» ҳангоми иҷро ҳам ёрӣ медиҳад: якчанд ҷавоб гирифтан ё як ҷавобро қадам ба қадам беҳтар кардан ба модели хурд имкон медиҳад, ки натиҷаи беҳтар диҳад.
Манбаъҳо
- Clarke, A. C. (1973). Profiles of the Future (нашри таҷдидшуда) — «қонуни сеюми Кларк».
- Shao, Z. ва ҳамкорон (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO). https://arxiv.org/abs/2402.03300
- Zheng, C. ва ҳамкорон (2025). Group Sequence Policy Optimization (GSPO).
- Inoue, Y. ва ҳамкорон (2025). Wider or Deeper? Scaling LLM Inference-Time Compute with Adaptive Branching Tree Search (AB-MCTS).
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё