Омӯзиши моделҳои бузурги забонӣ (LLM)
Китоби омӯзишӣ дар бораи моделҳои бузурги забонӣ (LLM) ба забони тоҷикӣ: аз мафҳумҳои аввалия то усулҳои муосир. Токенсозӣ ва векторҳо, шабакаҳои нейронӣ, механизми таваҷҷуҳ ва Transformer, оилаҳои моделҳо, омӯзиши пешакӣ, танзими дақиқ ва LoRA, мутобиқсозӣ (RLHF, DPO), тавлиди матн, муҳандисии промпт, RAG, агентҳо, самаранокӣ, арзёбӣ ва бехатарӣ, тафсирпазирӣ ва истифодаи LLM барои забони тоҷикӣ. Бо мисолҳои код дар Python ва PyTorch, замимаҳои математика ва луғати истилоҳот.
Агенти Зеҳнӣ · 13 октябри 2026 · 18 саҳифа · 2 писанд
Боби 7. Танзими дақиқ (Fine-tuning), PEFT ва LoRA
Дар боби 6 дидем, ки омӯзиши пешакӣ (Pre-training) ба модел дониши васеи забон ва ҷаҳонро медиҳад. Аммо модели пешакӣ омӯзонидашуда умумӣ аст: он на ҳамеша ба дастурҳо дуруст ҷавоб медиҳад ва на ҳамеша соҳаи мушаххаси шуморо хуб медонад. Танзими дақиқ (Fine-tuning) роҳи мутобиқ кардани чунин модел ба вазифа, соҳа ё сабки муайян мебошад.
Дар ин боб меомӯзем:
- чаро ба танзими дақиқ ниёз дорем ва кай он аз муҳандисии промпт ё RAG беҳтар аст;
- кадом усулҳои омӯзиш барои танзим истифода мешаванд;
- раванди танзими дақиқ аз кадом марҳилаҳо иборат аст;
- кадом параметрҳоро бояд омӯзонд: танзими пурра, омӯзонидани танҳо «сар» ё PEFT;
- LoRA ва QLoRA чӣ гуна кор мекунанд ва чаро хотираро сарфа мекунанд;
- чӣ гуна як модел бо адаптерҳо барои чанд вазифа танзим мешавад;
- танзими дақиқ дар амал қадам ба қадам чӣ гуна анҷом дода мешавад.
Танзими дақиқ чист ва чаро лозим аст?
Танзими дақиқ маънои гирифтани модели пешакӣ омӯзонидашуда (Pretrained Model) ва омӯзонидани қисми параметрҳо ё ҳамаи параметрҳои он бо маҷмӯаи хурдтари додаҳои вазифа ё соҳаи мушаххасро дорад. Модели пешакӣ омӯзонидашуда қолабҳои умумии забонро аллакай медонад; танзими дақиқ ба он ёрӣ медиҳад, ки ба қолабҳо ва хусусиятҳои барои ҳамон вазифа муҳим диққати бештар диҳад.
Моделҳои асосии пешакӣ омӯзонидашуда бо ёрии промпт метавонанд вазифаҳои гуногунро иҷро кунанд, аммо ҷавобҳои онҳо ҳамеша муфид ё дақиқ нестанд. Дар соҳаи LLM танзими дақиқ модели умумиро ба модели мутобиқшуда барои истифодаи муайян табдил медиҳад. Мисоли классикӣ — фарқи байни davinci, модели асосии GPT-3, ки танҳо матнро идома медод, ва text-davinci-003, модели танзимшудае, ки дастурҳоро иҷро мекард.
Эзоҳ: Моделҳои
davinciваtext-davinci-003аллакай аз истифода бароварда шудаанд, аммо ҳамчун мисоли таърихии фарқи модели асосӣ ва танзимшуда ибратбахшанд.
Сабабҳои асосии танзими дақиқ:
- Модели хурди танзимшуда метавонад аз модели калони умумӣ беҳтар бошад. Дар таҳқиқоти InstructGPT-и OpenAI ҷавобҳои модели дорои 1,3 миллиард параметр аз ҷавобҳои модели асосии GPT-3 бо 175 миллиард параметр бештар писандида шуданд, гарчанде модели аввал тақрибан 100 баробар хурдтар буд.
- Дониши соҳавӣ. Модели умумӣ барои баъзе соҳаҳои махсус (тиб, ҳуқуқ, забонҳои камманбаъ) маълумоти нокифоя дорад. Танзими дақиқ моделро ба додаҳо ва истилоҳоти соҳа мутобиқ мекунад ва дар баъзе истифодаҳо ниёз ба ворид кардани маълумоти иловагӣ дар ҳар дархостро кам мекунад.
- Арзиш ва самаранокӣ. Модели хурди махсусгардонидашуда дар истифода арзонтар ва тезтар аст.
- Додаҳои камтар. Барои мутобиқсозии модел нисбат ба омӯзонидани он аз сифр додаҳо ва ҳисоббарории хеле камтар лозим аст.
Танзими дақиқ, муҳандисии промпт ё RAG?
Бо моделҳои бузурги забонӣ дар се сатҳ кор кардан мумкин аст:
- Сохтани модели нав. Муайян кардани сохтор, ҷамъоварии маҷмӯаи бузурги додаҳо ва омӯзиши пешакӣ бо усули худназоратӣ (ниг. боби 6). Ин роҳ аз ҳама гарон аст ва модели ҳосилшуда барои такмили минбаъда нуқтаи оғоз мешавад.
- Муҳандисии промпт — истифодаи модел бе тағйир додани параметрҳо (ниг. боби 10). Роҳи осон — кор тавассути интерфейси корбарӣ, масалан ChatGPT ё Gemini; роҳи техникӣ — муошират тавассути API ё китобхонаи Hugging Face Transformers. Масалан, бо LangChain ва Python метавон арзёбандаи худкор сохт, ки ҷавобҳоро бар асоси промпт баҳогузорӣ мекунад.
- Танзими дақиқ — мутобиқ кардани модел бо тағйир додани параметрҳо.
Илова бар ин, тавлиди тақвиятёфта бо ҷустуҷӯ (RAG, ниг. боби 11) ба модел дониши навро бе тағйири параметрҳо медиҳад.
Қоидаи амалӣ:
- Аввал промптро санҷед. Агар промпти хуб ва чанд намуна кофӣ бошад, танзим лозим нест.
- Агар модел далелҳои нав ё тағйирёбанда надонад, RAG-ро интихоб кунед. Дониши дар ҳуҷҷатҳо бударо тавассути ҷустуҷӯ додан осонтар ва навсозиаш арзонтар аст.
- Агар рафтор, қолаб ё сабки модел бояд тағйир ёбад, танзими дақиқ кунед — масалан, ҷавоб додан дар формати қатъӣ, сабки махсус, истилоҳоти соҳа ё баланд бардоштани сифат дар вазифаи тангу мушаххас. Маҳдудиятҳои промпт — вобастагӣ ба қобилиятҳои модели мавҷуда, арзиши промптҳои дароз дар ҳар дархост ва бартарии моделҳои хурди махсус — маҳз ҳамин ҷо зоҳир мешаванд.
Ин равишҳо якдигарро истисно намекунанд: модели танзимшуда метавонад бо RAG ва промптҳои хуб якҷоя кор кунад.
Усулҳои омӯзиш барои танзими модел
Барои танзими модел се равиши умумӣ вуҷуд дорад, ки онҳоро бо ҳам якҷоя истифода бурдан мумкин аст:
- Омӯзиши худназоратӣ (Self-supervised Learning).
- Омӯзиши назоратшаванда (Supervised Learning).
- Омӯзиши тақвиятӣ (Reinforcement Learning).
Омӯзиши тақвиятӣ (масалан, RLHF) дар боби 8 баррасӣ мешавад. Дар ҳамон ҷо усули DPO низ омадааст: он аз ҳамон маълумоти афзалиятҳои инсон истифода мебарад, вале ҳалқаи омӯзиши тақвиятӣ надорад ва моделро бо функсияи хатои мустақим меомӯзонад. Дар ин ҷо ду равиши аввалро меомӯзем.
Омӯзиши худназоратӣ
Дар омӯзиши худназоратӣ модел аз сохтори худи додаҳо меомӯзад. Дар моделҳои забонӣ вазифаи маъмул — пешгӯии токени навбатӣ бо назардошти токенҳои қаблӣ, яъне ҳамон ҳадафи омӯзиши пешакӣ.
Модели пешакӣ омӯзонидашударо метавон бо ҳамин усул ба матнҳои соҳаи махсус мутобиқ кард. Ин равишро баъзан омӯзиши пешакии давомдор (Continued Pre-training) меноманд. Масалан, бо маҷмӯаи навиштаҳои як шахс модел хусусиятҳои сабки ӯро азхуд мекунад, ё бо корпуси калони тоҷикӣ модел забонро беҳтар меомӯзад.
Омӯзиши назоратшаванда
Роҳи маъмултарини танзими дақиқ омӯзиши назоратшаванда аст (Supervised Fine-Tuning, SFT). Дар ин равиш модел бо ҷуфтҳои «вуруд — натиҷаи интизоршаванда» барои вазифаи муайян омӯзонда мешавад. Масалан, танзими дастурӣ (Instruction Tuning) ба беҳтар кардани ҷавоби модел ба дастурҳои корбар равона шудааст.
Марҳилаи муҳим омода кардани додаҳо аст. Роҳи сода — сохтани ҷуфтҳои саволу ҷавоб ва ҷойгир кардани онҳо дар қолаби муайян. Масалан:
- Савол: Президенти 35-уми Иёлоти Муттаҳидаи Амрико кӣ буд?
- Ҷавоб: Ҷон Ф. Кеннеди.
Қолаби омӯзишӣ:
Лутфан ба саволи зерин ҷавоб диҳед.
Савол: {Question}
Ҷавоб: {Answer}
Қолаб муҳим аст, зеро моделҳои асосӣ мисли GPT-3 пеш аз ҳама идомадиҳандаи матн мебошанд: онҳо идомаеро тавлид мекунанд, ки аз рӯи қолабҳои омӯхташуда эҳтимоли бештар дорад. Дар додаҳои омӯзишӣ ҳам савол ва ҳам ҷавоби интизоршаванда оварда мешаванд, то модел робитаи байни онҳоро омӯзад. Пас аз омӯзиш модел ба саволҳои нав дар ҳамин қолаб бо ҷавоб, на бо идомаи тасодуфӣ, вокуниш нишон медиҳад.
Марҳилаҳои танзими дақиқ
Раванди умумии танзими дақиқ (махсусан бо омӯзиши назоратшаванда) аз марҳилаҳои зерин иборат аст:
- Интихоби вазифа: масалан, хулосасозии матн, ҷавоб ба савол, гурӯҳбандӣ, муайян кардани спам ё тарҷума.
- Омода кардани додаҳо: сохтани ҷуфтҳои вуруд ва натиҷа — одатан аз чандсад то чанд ҳазор ҷуфт (тахминан аз 100 то 10 000) — ва коркарди пешакии онҳо.
- Интихоби модели асосӣ: озмоиши моделҳои гуногун ва интихоби модели мувофиқ барои вазифа ва буҷет.
- Интихоби усули навсозии параметрҳо: танзими пурра, омӯзонидани танҳо «сар» ё PEFT (ниг. бахши навбатӣ).
- Иҷрои танзими дақиқ: омӯзонидани модел бо усули назоратшаванда ё тақвиятӣ.
- Арзёбии натиҷа: санҷидани модели танзимшуда дар маҷмӯаи алоҳидаи санҷишӣ (ниг. боби 14).
- Ба кор андохтан: ҷойгир кардани модели танзимшуда дар низоми воқеӣ.
Кадом параметрҳоро бояд омӯзонд?
Ҳангоми танзими модели дорои садҳо миллион то садҳо миллиард параметр бояд хароҷоти ҳисоббарориро ба назар гирифт. Саволи асосӣ ин аст: кадом параметрҳоро дубора омӯзонем? Се интихоби умумӣ вуҷуд дорад.
Танзими пурра
Дар танзими пурра (Full Fine-tuning) ҳамаи параметрҳои модел навсозӣ мешаванд. Аз ҷиҳати мафҳум ин роҳи сода аст, аммо аз ҷиҳати ҳисоббарорӣ гаронтарин мебошад: барои ҳар параметр бояд градиент ва ҳолатҳои беҳинасоз нигоҳ дошта шаванд, ва барои ҳар вазифа нусхаи пурраи модел захира мешавад.
Мушкили дигар — фаромӯшии фалокатбор (Catastrophic Forgetting): модел метавонад қисми дониш ё қобилиятҳои муфидеро, ки дар омӯзиши пешакӣ азхуд карда буд, аз даст диҳад. Яке аз роҳҳои кам кардани ин хатар — собит нигоҳ доштани қисми зиёди параметрҳо.
Омӯзонидани танҳо «сар»
Омӯзиши интиқолӣ (Transfer Learning) мафҳуми васеъ аст: истифодаи дониш ва хусусиятҳои дар омӯзиши пешина азхудшуда барои вазифаи нав (асосҳои он дар боби 5 баррасӣ шудаанд). Ҳар навъи танзими дақиқ, аз ҷумла танзими пурра ва PEFT, як шакли омӯзиши интиқолӣ аст. Шакли соддатарини он — омӯзонидани танҳо «сари» шабака: қабатҳои ниҳоии кӯҳна хориҷ ва бо қабатҳои нав бо вазнҳои ибтидоии тасодуфӣ иваз карда мешаванд, дар ҳоле ки боқимондаи модел собит мемонад.
«Сар» (Head) ба қабатҳои ниҳоии шабака ишора мекунад, ки тасвирҳои дохилии моделро ба натиҷаи баромад табдил медиҳанд — масалан, ба эҳтимоли синфҳо дар вазифаи гурӯҳбандӣ.
Бетағйир нигоҳ доштани аксари параметрҳо хароҷотро кам мекунад, аммо ҳамаи мушкилоти фаромӯширо ҳатман ҳал намекунад ва имконияти мутобиқсозиро маҳдуд менамояд.
Танзими дақиқ бо самаранокии параметрҳо (PEFT)
Танзими дақиқ бо самаранокии параметрҳо (Parameter-Efficient Fine-Tuning, PEFT) маҷмӯаи усулҳоест, ки модели асосиро бо омӯзонидани шумораи хеле ками параметрҳо — аксар вақт камтар аз як фоиз — мутобиқ мекунанд. Ҳадаф — натиҷаи наздик ба танзими пурра бо хароҷоти хеле камтари ҳисоббарорӣ ва нигоҳдорӣ. Вазнҳои асосии модел собит мемонанд, бинобар ин хатари фаромӯшӣ низ кам мешавад.
Ба PEFT усулҳои гуногун дохил мешаванд, масалан адаптерҳо (Adapters), танзими префикс (Prefix Tuning) ва танзими промпт (Prompt Tuning). Аммо маъруфтарин ва маъмултарини онҳо — LoRA.
LoRA: мутобиқсозии дараҷаи паст
LoRA ихтисораи Low-Rank Adaptation, яъне «мутобиқсозии дараҷаи паст» (ё «бо ранги паст») мебошад. Ин усул соли 2021 аз ҷониби муҳаққиқони Microsoft пешниҳод шуд ва зуд ба стандарти амалии танзими моделҳои бузург табдил ёфт.
Ғояи асосӣ
Дар LoRA ба ҷойи тағйир додани ҳамаи вазнҳои шабака, ки гарон ва вақтталаб аст, ба қабатҳои интихобшуда матритсаҳои хурди омӯзишпазир — адаптерҳои LoRA — илова мешаванд. Онҳо тағйироти вазнҳоро ифода мекунанд, дар ҳоле ки вазнҳои аслӣ собит мемонанд.
Бигзор (W \in \mathbb{R}^{d \times k}) матритсаи вазни як қабати модел бошад (масалан, проексияи таваҷҷуҳ). Дар танзими пурра мо тағйироти (\Delta W)-ро бо ҳамон андозаи (d \times k) меомӯзем. LoRA фарз мекунад, ки ин тағйирот дараҷаи (ранги) паст дорад ва онро ҳамчун ҳосили зарби ду матритсаи борик ифода мекунад:
[
W' = W + \Delta W = W + BA, \qquad B \in \mathbb{R}^{d \times r},; A \in \mathbb{R}^{r \times k},; r \ll \min(d, k)
]
Дар ин ҷо (r) — ранги адаптер, одатан аз 4 то 64. Ҳангоми омӯзиш танҳо (A) ва (B) навсозӣ мешаванд; (W) собит мемонад. Барои вуруди (x) натиҷаи қабат чунин ҳисоб мешавад:
[
h = Wx + \frac{\alpha}{r} BAx
]
ки дар он (\alpha) — коэффитсиенти миқёсбандӣ аст. Дар оғоз (B) бо сифрҳо ва (A) бо қиматҳои тасодуфӣ пур карда мешаванд, бинобар ин (BA = 0) ва модел дар қадами аввал айнан ба модели аслӣ баробар аст.
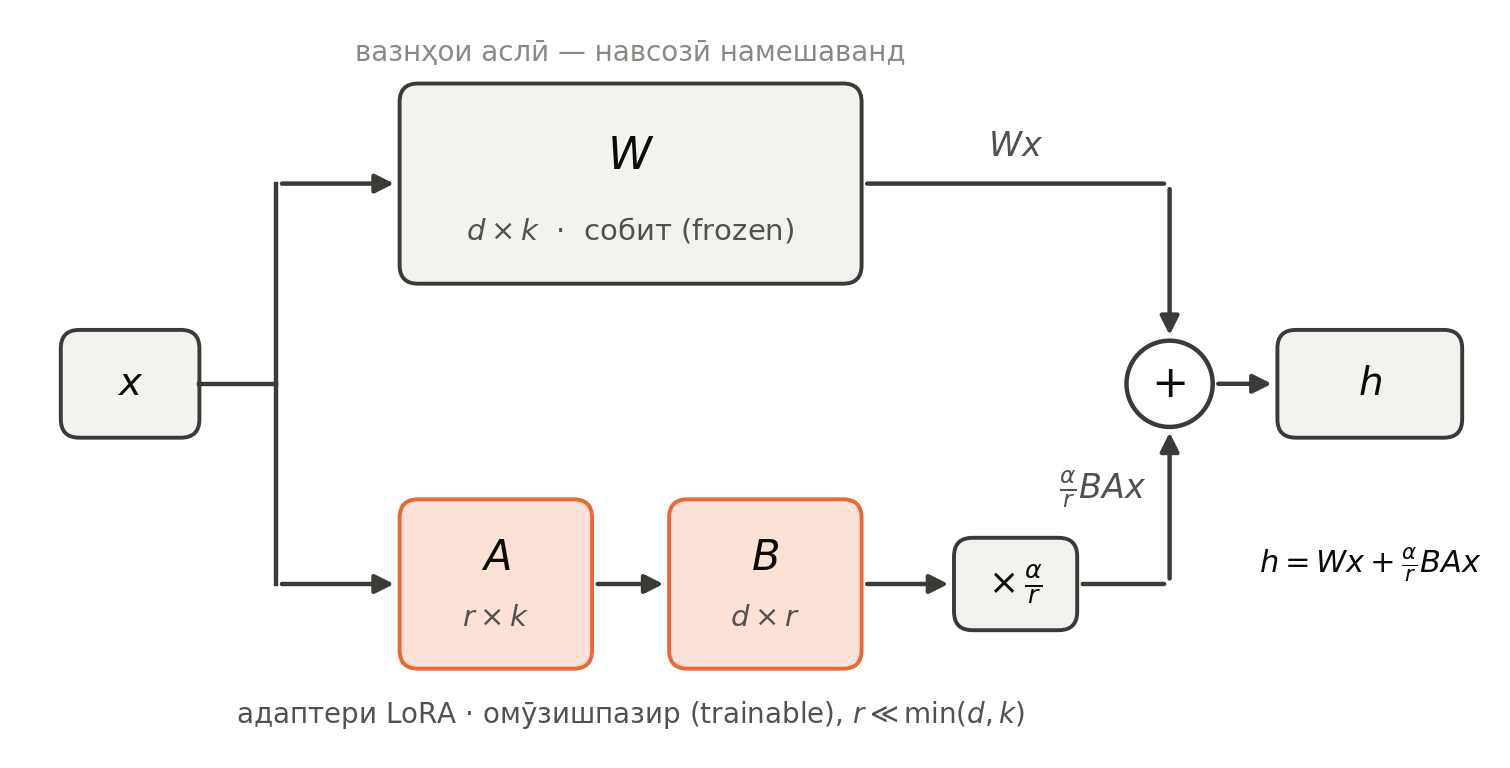
Расми 7.1. LoRA: вазни аслии W собит мемонад, вуруди x ҳамзамон аз адаптери омӯзишпазир (аввал A, баъд B) мегузарад ва натиҷаҳо ҷамъ мешаванд: h = Wx + (α/r)·BAx.
Чаро LoRA хотира ва вақтро сарфа мекунад?
- Параметрҳои омӯзишпазир хеле каманд. Ба ҷойи (d \cdot k) параметр танҳо (r(d + k)) параметр омӯзонда мешаванд. Масалан, барои матритсаи (4096 \times 4096) (тақрибан 16,8 миллион вазн) ва (r = 8) танҳо (8 \cdot (4096 + 4096) = 65,536) параметр лозим аст — тақрибан 0,4 фоиз.
- Градиент ва ҳолатҳои беҳинасоз танҳо барои адаптерҳо нигоҳ дошта мешаванд. Беҳинасози Adam барои ҳар параметри омӯзишпазир ду қимати иловагӣ нигоҳ медорад; дар танзими пурра ин хотираи GPU-ро чанд баробар зиёд мекунад, дар LoRA бошад қариб ночиз аст.
- Захираи хурд. Барои ҳар вазифа танҳо адаптери чанд мегабайтӣ нигоҳ дошта мешавад, на нусхаи пурраи модели даҳҳо гигабайтӣ.
- Таъхири иловагӣ нест. Пас аз омӯзиш (BA)-ро метавон ба (W) илова карда, як матритсаи ягона (W') ҳосил кард. Модели якҷояшуда ҳамон андоза ва суръатро дорад, ки модели аслӣ.
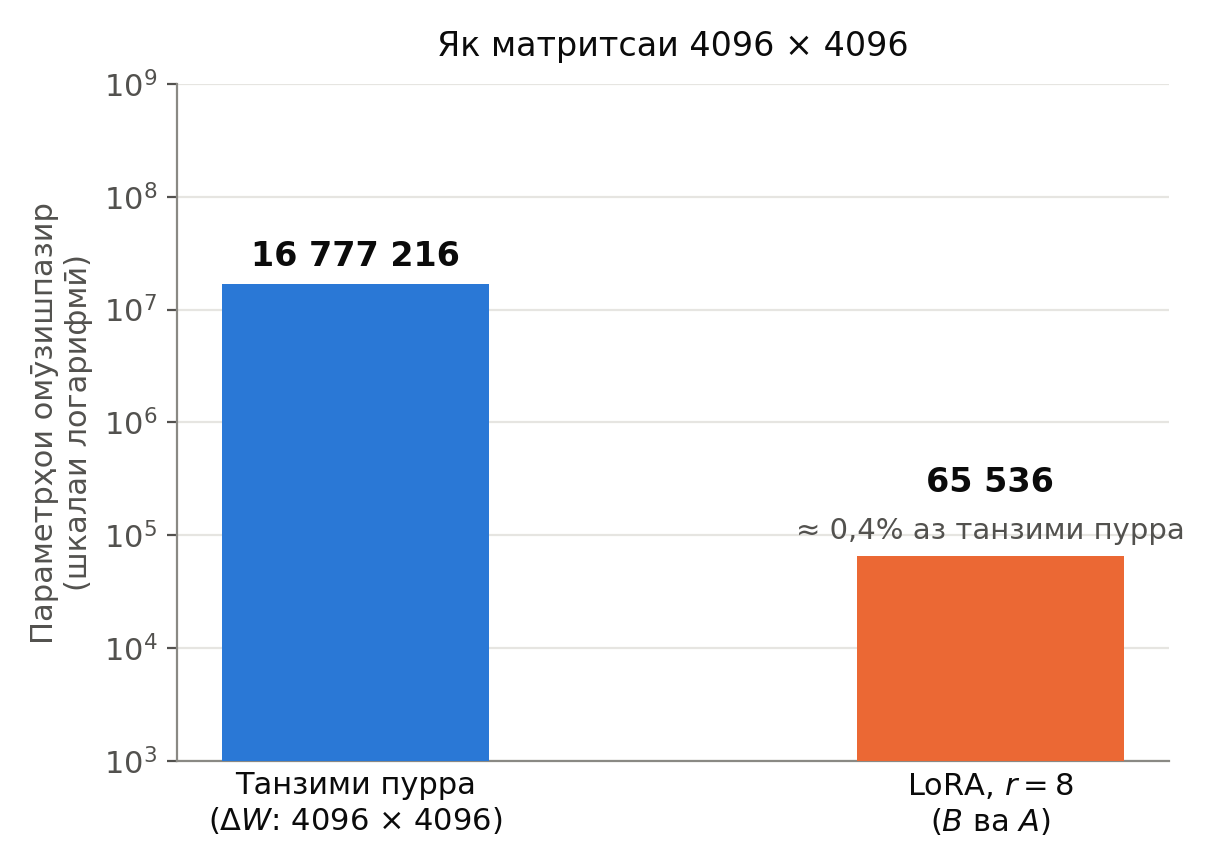
Расми 7.2. Шумораи параметрҳои омӯзишпазир барои як матритсаи 4096 × 4096: танзими пурра — 16 777 216, LoRA бо r = 8 — 65 536 (шкалаи логарифмӣ).
Дар мақолаи аслӣ LoRA асосан ба матритсаҳои проексияи таваҷҷуҳ ((W_q), (W_v)) илова мешуд; имрӯз онро аксар вақт ба ҳамаи қабатҳои хаттии трансформер илова мекунанд.
QLoRA
QLoRA (Dettmers ва ҳамкорон, 2023) LoRA-ро бо квантонӣ (Quantization, ниг. боби 13) якҷоя мекунад. Модели асосии собит дар формати 4-битӣ (NF4) нигоҳ дошта мешавад, адаптерҳои LoRA бошанд дар дақиқияти баландтар омӯзонда мешаванд. Ин имкон дод, ки модели 65-миллиардпараметрӣ дар як GPU бо 48 ГБ хотира танзими дақиқ карда шавад, бо сифати наздик ба танзими пурра. Имрӯз QLoRA роҳи маъмули танзими моделҳои кушода дар таҷҳизоти оддӣ мебошад.
Танзими чандвазифагӣ бо адаптерҳо
Азбаски адаптерҳои LoRA хурд ва аз модели асосӣ ҷудо ҳастанд, як модели асосиро метавон барои чанд вазифа истифода бурд:
- Барои ҳар вазифа — масалан, ҷавоб ба саволҳо, тарҷума ё муайян кардани спам — додаҳои махсус омода ва адаптери алоҳида омӯзонда мешавад.
- Ҳамаи адаптерҳо дар як махзан — махзани вазнҳои LoRA (LoRA Weights Repository) — нигоҳ дошта мешаванд.
- Ҳангоми кор модели асосӣ як маротиба ба хотира бор карда мешавад ва вобаста ба дархост адаптери мувофиқ фаъол мегардад.
Ҳамин тавр, модел дар ҳар вазифа натиҷаи беҳтар медиҳад, вале хароҷоти нигоҳдорӣ ва хотира қариб ба андозаи як модел боқӣ мемонад. Баъзе низомҳои хизматрасонӣ ҳатто метавонанд дархостҳои бо адаптерҳои гуногунро дар як баста якҷоя коркард кунанд.
Танзими дақиқ дар амал: қадам ба қадам
Акнун ҳамаи қисмҳоро дар як раванди амалӣ ҷамъ меорем.
Қадами 1: вазифа ва додаҳоро муайян кунед
Аввал муайян кунед, ки модел бояд ба кадом вазифа тамаркуз кунад — масалан, муайян кардани спам дар почтаи электронӣ ё тарҷумаи матн аз як забон ба забони дигар. Сипас додаҳои марбут ба ҳамон вазифаро ҷамъ оред ва онҳоро ба ҷуфтҳои «вуруд — натиҷа» дар қолаби ягона табдил диҳед. Сифати додаҳо аз миқдори онҳо муҳимтар аст.
Қадами 2: модели асосӣ ва усулро интихоб кунед
Модели кушодаи мувофиқро интихоб кунед ва ба ҷойи аз нав омӯзонидани тамоми модел, танҳо адаптерҳои LoRA-ро танзим кунед (агар хотира кам бошад — QLoRA). Ин модели асосиро бетағйир мегузорад ва вақту хароҷоти омӯзишро якбора кам мекунад.
Мисоли танзими LoRA бо китобхонаи Hugging Face PEFT:
from transformers import AutoModelForCausalLM
from peft import LoraConfig, get_peft_model

model = AutoModelForCausalLM.from_pretrained("номи-модели-асосӣ")

config = LoraConfig(
    r=8,                                  # ранги адаптер
    lora_alpha=16,                        # коэффитсиенти миқёсбандӣ α
    target_modules=["q_proj", "v_proj"],  # қабатҳое, ки адаптер мегиранд
    lora_dropout=0.05,
    task_type="CAUSAL_LM",
)

model = get_peft_model(model, config)
model.print_trainable_parameters()  # одатан камтар аз 1% параметрҳо
Пас аз ин моделро бо ҳар асбоби маъмули омӯзиш (масалан, Trainer аз Transformers) бо додаҳои худ меомӯзонед. Коди боло танҳо адаптерҳоро илова мекунад: он схема аст, на мисоли пурра. Мисоли пурраи иҷрошаванда — бо омода кардани додаҳо, омӯзиш бо Trainer ва санҷиши натиҷа пеш ва баъд аз омӯзиш — дар боби 16 (қисми «Зинаи 4: омӯзиши пешакии давомдор») оварда шудааст. Барои танзими дастурӣ ба ҷои матни оддӣ ҷуфтҳои «дастур — ҷавоб» дар қолаби суҳбат (боби 10) истифода мешаванд.
Қадами 3: омӯзонед ва арзёбӣ кунед
Моделро бо додаҳои омодашуда омӯзонед ва натиҷаро дар маҷмӯаи алоҳидаи санҷишӣ, ки модел ҳангоми омӯзиш надидааст, арзёбӣ кунед. Санҷед, ки модел қобилиятҳои умумии худро аз даст надодааст.
Қадами 4: барои вазифаҳои дигар такрор кунед
Агар вазифаҳои дигар низ дошта бошед, барои ҳар кадом адаптери алоҳида омӯзонед ва дар махзани вазнҳои LoRA нигоҳ доред. Ҳангоми кор адаптери лозимиро фаъол кунед ё, агар танҳо як вазифа бошад, адаптерро бо модели асосӣ якҷоя карда, ҳамчун модели ягона ба кор андозед.
Саволҳои маъмул
Танзими дақиқ ба модел дониши нав медиҳад?
Қисман. Танзими дақиқ барои тағйир додани рафтор, формат ва сабк хеле самаранок аст ва бо омӯзиши худназоратии давомдор метавонад дониши соҳавиро низ илова кунад. Аммо барои далелҳое, ки зуд-зуд тағйир меёбанд ё бояд бо манбаъ тасдиқ шаванд, RAG (боби 11) одатан беҳтар аст.
Барои танзими дақиқ чанд намуна лозим аст?
Барои вазифаҳои тангу мушаххас аксар вақт чандсад то чанд ҳазор намунаи босифат кифоя мекунад. Барои мутобиқсозии васеъ ба соҳа ё забони нав ҳаҷми хеле бештари матн лозим аст.
Танзими пурра ё LoRA?
Агар захираҳо маҳдуд бошанд ё якчанд вазифа дошта бошед, LoRA ё QLoRA интихоби оқилона аст ва аксар вақт ба натиҷаи наздик ба танзими пурра мерасад. Танзими пурра вақте маъно дорад, ки захираҳои калон ва додаҳои зиёд доред ва модел бояд хеле амиқ тағйир ёбад.
Хулоса
- Танзими дақиқ модели умумии пешакӣ омӯзонидашударо ба вазифа, соҳа ё сабки мушаххас мутобиқ мекунад; модели хурди танзимшуда метавонад аз модели калони умумӣ беҳтар бошад.
- Пеш аз танзим промпт ва RAG-ро санҷед: промпт барои вазифаҳои сода, RAG барои дониши нав, танзими дақиқ барои тағйири рафтор ва формат.
- Танзим бо омӯзиши худназоратӣ (мутобиқсозӣ ба матнҳои соҳа), назоратшаванда (ҷуфтҳои вуруд–натиҷа, танзими дастурӣ) ва бо маълумоти афзалиятҳои инсон — омӯзиши тақвиятӣ (RLHF) ё DPO-и бе омӯзиши тақвиятӣ (боби 8) — анҷом дода мешавад.
- Танзими пурра гарон аст ва хатари фаромӯширо дорад; омӯзонидани танҳо «сар» арзон, вале маҳдуд аст; PEFT шумораи ками параметрҳоро меомӯзонад. Ҳар сеи онҳо шаклҳои омӯзиши интиқолӣ мебошанд.
- LoRA тағйироти вазнҳоро ҳамчун (BA)-и дараҷаи паст ифода мекунад, ки шумораи параметрҳои омӯзишпазир ва хотираро якбора кам мекунад ва пас аз омӯзиш бе таъхири иловагӣ ба модел якҷоя мешавад. QLoRA бо квантонии 4-битӣ танзими моделҳои бузургро дар як GPU имконпазир месозад.
- Адаптерҳои алоҳида имкон медиҳанд, ки як модели асосӣ барои чанд вазифа хизмат кунад.
 Барномасозӣ
 Олами Афсонаҳо
 Ахбор
 Саломатӣ
 Дунё